A través del análisis de un conjunto de datos clínicos, se busca identificar posibles asociaciones entre el uso de antibióticos y los resultados del tratamiento, medidos mediante la escala RCB (Residual Cancer Burden), la supervivencia y el riesgo de recaída.
Este estudio es relevante porque, aunque se ha explorado en otros tipos de cáncer, el impacto de los antibióticos en la respuesta neoadyuvante del cáncer de mama aún no está bien establecido. El análisis permitirá comprender mejor si el uso de antibióticos afecta la probabilidad de alcanzar una respuesta patológica completa, lo que podría tener implicaciones en la personalización del tratamiento oncológico.
Estadística descriptiva
El conjunto de datos cuenta con las siguientes variables:
Edad en años en la que se realizó el diagnóstico del cáncer.
Estado menopáusico de la paciente al momento del diagnóstico (premenopáusica, menopáusica o desconocido).
Tipo histológico del tumor, según clasificación patológica.
Grado histológico del tumor.
Expresión del marcador de proliferación celular Ki-67.
Clasificación del tumor según inmunohistoquímica.
Tamaño del tumor en centímetros.
Clasificación T del tumor.
Estado ganglionar.
Estadio clínico del cáncer.
Tipo de cirugía realizada.
Tipo de quimioterapia neoadyuvante administrada.
Respuesta completa patológica tras el tratamiento.
Hormonoterapia adyuvante recibida.
Receptores hormonales de estrógeno (RE) y progesterona (RP).
Indica si hubo o no retrasos.
En primer lugar se ha procedido con el estudio individual de cada variable de interés teniendo en cuenta tanto el tipo de variable como bien su resumen estadístico que se ha acompañado con representaciones gráficas.
Para el análisis univariante de estas variables, se ha implementado una función que automatiza el proceso para las variables de interés del conjunto. De esta forma, conseguimos conocer qué variables son numéricas y cuáles son categóricas. También, se muestran resúmenes estadísticos de cada una de las variables junto a representaciones gráficas.
Código
variables_a_analizar <-c("EDAD_DIAGNOSTICO", "ESTADO_MENOPAUSICO", "HISTOLOGIA", "GRADO", "KI67_DICOT", "Ki67", "FENOTIPO_IHQ", "TAMAÑO", "Tn", "Nx", "ESTADIO", "TIPO_CIRUGIA", "TIPO_QT_NEOADY_OK", "RCB", "HT_ADY_OK", "RE", "RP", "RETRASOS", "No_ANTIBIOTICOS", "FECHA_ULTIMO_CONTROL", "FECHA_INICIO_QT", "ESTADO_ULTIMO_CONTROL", "ANTIBIOTICO")resultados <-analizar_variables(muestra_700_UGC_perdidos, variables_a_analizar)Numericas <-names(resultados$Numericas) # Ver nombres de variables numéricasCategoricas <-names(resultados$Categoricas) # Ver nombres de variables categóricas
Una vez conocidas las variables y el tipo de las mismas se va a proceder con el análisis estadístico para cada una.
Se va a proceder con la detección e imputación de valores perdidos, así como la identificación de valores atípicos. También, se realizará un preprocesamiento de los datos que conlleva una categorización y recodificación de variables para estratificar adecuadamente la población de pacientes. De esta forma pasamos de 700 muestras a 217.
Código
# Llamar la función y procesar el datasetdf_procesado <-procesar_datos(muestra_700_UGC_perdidos, variables_a_analizar)# Mostrar el dataset procesadoskim_without_charts(df_procesado)
Data summary
Name
df_procesado
Number of rows
217
Number of columns
23
_______________________
Column type frequency:
factor
17
numeric
6
________________________
Group variables
None
Variable type: factor
skim_variable
n_missing
complete_rate
ordered
n_unique
top_counts
ESTADO_MENOPAUSICO
0
1
FALSE
2
PRE: 112, MEN: 105
HISTOLOGIA
0
1
FALSE
9
DUC: 190, LOB: 15, PAP: 3, APO: 2
GRADO
0
1
FALSE
3
3: 111, 2: 99, 1: 7
KI67_DICOT
0
1
FALSE
2
AIP: 177, BIP: 40
FENOTIPO_IHQ
0
1
FALSE
5
LUM: 56, TRI: 50, LUM: 48, HER: 35
Tn
0
1
FALSE
4
2: 155, 1: 26, 3: 22, 4: 14
Nx
0
1
FALSE
4
1: 107, 0: 77, 2: 25, 3: 8
ESTADIO
0
1
FALSE
8
IIB: 78, IIA: 74, III: 29, III: 18
TIPO_CIRUGIA
0
1
FALSE
2
CON: 138, RAD: 79
TIPO_QT_NEOADY_OK
0
1
FALSE
9
ANT: 123, QUI: 40, QUI: 39, TAX: 7
RCB
0
1
FALSE
4
RCB: 81, RCB: 62, RCB: 51, RCB: 23
HT_ADY_OK
0
1
FALSE
8
NO: 82, INH: 55, TAM: 44, TAM: 18
RETRASOS
0
1
FALSE
2
NO: 157, SI: 60
FECHA_ULTIMO_CONTROL
0
1
FALSE
167
11/: 4, 14/: 3, 16/: 3, 18/: 3
FECHA_INICIO_QT
0
1
FALSE
201
04/: 2, 04/: 2, 06/: 2, 10/: 2
ESTADO_ULTIMO_CONTROL
0
1
FALSE
4
VSE: 163, VCE: 28, MCE: 24, MSE: 2
ANTIBIOTICO
0
1
FALSE
2
NO: 123, SI: 94
Variable type: numeric
skim_variable
n_missing
complete_rate
mean
sd
p0
p25
p50
p75
p100
EDAD_DIAGNOSTICO
0
1
52.84
10.94
28.0
45.0
51
60
79.0
Ki67
0
1
43.20
26.18
4.0
20.0
37
67
100.0
TAMAÑO
0
1
3.31
1.25
0.6
2.5
3
4
6.8
RE
0
1
52.56
45.50
0.0
0.0
75
95
100.0
RP
0
1
28.26
37.40
0.0
0.0
0
60
100.0
No_ANTIBIOTICOS
0
1
0.58
0.74
0.0
0.0
0
1
2.0
Categorización y recodificación de variables
Se han creado variables categóricas nuevas a partir de las originales para simplificar la interpretación. Los criterios utilizados han sido:
GRADO_CAT: agrupación en dos categorías:
1/2 → Grado 1 o 2
3 → Grado 3
HISTOLOGIA_CAT:
DUCTAL → Tumores ductales
NO DUCTAL → Todos los demás tipos histológicos
Ki67_CAT:
<=14 → Marcador Ki-67 menor o igual a 14%
>14 → Mayor a 14%
FENOTIPO_IHQ_CAT:
LUMINAL → Fenotipos Luminal A o B
HER2 → Tumores HER2 o Luminal-HER2
TRIPLE NEGATIVO → Resto
ESTADIO_CAT:
I → Estadio I, IA, IB
II → II, IIA, IIB
III → III, IIIA, IIIB, IIIC
QT_CAT:
NO antiHER2 → Quimioterapia sin antiHER2
antiHER2 → Combinación con fármacos antiHER2
INMUNO → Incluye inmunoterapia
No_ANTIBIOTICOS:
Una vez → 1 ciclo antibiótico
Dos veces o más → 2 o más ciclos
RCP: respuesta completa patológica calculada a partir de RCB:
SI → RCB-0 o RCB-1
NO → RCB-2 o RCB-3
EDAD_DIAGNOSTICO:
0-39
40-49
50-59
60-69
70-79
≥80
Código
df_procesado$EDAD_DIAGNOSTICO <-cut(df_procesado$EDAD_DIAGNOSTICO, breaks =c(-Inf, 39, 49, 59,69,79, Inf), labels =c("0-39", "40-49", "50-59", "60-69","70-79","≥80"))df_procesado$EDAD_DIAGNOSTICO <-as.factor(df_procesado$EDAD_DIAGNOSTICO)# Seleccionar variables numéricasnumeric_vars <-sapply(df_procesado, is.numeric)# Excluir 'Ki67' y 'No_ANTIBIOTICOS' de la normalizaciónvars_a_normalizar <-setdiff(names(df_procesado)[numeric_vars], c("Ki67", "No_ANTIBIOTICOS"))# Normalizar solo esas variablesnormalized_data <-scale(df_procesado[, vars_a_normalizar])# Reemplazar las columnas originales por las normalizadasdf_procesado[, vars_a_normalizar] <- normalized_datadataset_recodificado <-preprocesar_datos(df_procesado)skim_without_charts(dataset_recodificado)
Data summary
Name
dataset_recodificado
Number of rows
217
Number of columns
31
_______________________
Column type frequency:
factor
26
numeric
5
________________________
Group variables
None
Variable type: factor
skim_variable
n_missing
complete_rate
ordered
n_unique
top_counts
EDAD_DIAGNOSTICO
0
1.00
FALSE
5
40-: 69, 50-: 64, 60-: 44, 0-3: 21
ESTADO_MENOPAUSICO
0
1.00
FALSE
2
PRE: 112, MEN: 105
HISTOLOGIA
0
1.00
FALSE
9
DUC: 190, LOB: 15, PAP: 3, APO: 2
GRADO
0
1.00
FALSE
3
3: 111, 2: 99, 1: 7
KI67_DICOT
0
1.00
FALSE
2
AIP: 177, BIP: 40
FENOTIPO_IHQ
0
1.00
FALSE
5
LUM: 56, TRI: 50, LUM: 48, HER: 35
Tn
0
1.00
FALSE
4
2: 155, 1: 26, 3: 22, 4: 14
Nx
0
1.00
FALSE
4
1: 107, 0: 77, 2: 25, 3: 8
ESTADIO
0
1.00
FALSE
8
IIB: 78, IIA: 74, III: 29, III: 18
TIPO_CIRUGIA
0
1.00
FALSE
2
CON: 138, RAD: 79
TIPO_QT_NEOADY_OK
0
1.00
FALSE
9
ANT: 123, QUI: 40, QUI: 39, TAX: 7
RCB
0
1.00
FALSE
4
RCB: 81, RCB: 62, RCB: 51, RCB: 23
HT_ADY_OK
0
1.00
FALSE
8
NO: 82, INH: 55, TAM: 44, TAM: 18
RETRASOS
0
1.00
FALSE
2
NO: 157, SI: 60
FECHA_ULTIMO_CONTROL
0
1.00
FALSE
167
11/: 4, 14/: 3, 16/: 3, 18/: 3
FECHA_INICIO_QT
0
1.00
FALSE
201
04/: 2, 04/: 2, 06/: 2, 10/: 2
ESTADO_ULTIMO_CONTROL
0
1.00
FALSE
4
VSE: 163, VCE: 28, MCE: 24, MSE: 2
ANTIBIOTICO
0
1.00
FALSE
2
NO: 123, SI: 94
GRADO_CAT
0
1.00
FALSE
2
3: 111, 1/2: 106
HISTOLOGIA_CAT
0
1.00
FALSE
2
DUC: 190, NO : 27
Ki67_CAT
0
1.00
FALSE
2
>14: 192, <=1: 25
FENOTIPO_IHQ_CAT
0
1.00
FALSE
3
LUM: 84, HER: 83, TRI: 50
ESTADIO_CAT
0
1.00
FALSE
3
II: 152, III: 54, I: 11
QT_CAT
1
1.00
FALSE
3
NO : 135, ant: 79, INM: 2
No_ANTIBIOTICOS_CAT
123
0.43
FALSE
2
Una: 62, Dos: 32
RCP
0
1.00
FALSE
2
NO: 132, SI: 85
Variable type: numeric
skim_variable
n_missing
complete_rate
mean
sd
p0
p25
p50
p75
p100
Ki67
0
1
43.20
26.18
4.00
20.00
37.00
67.00
100.00
TAMAÑO
0
1
0.00
1.00
-2.17
-0.65
-0.25
0.55
2.80
RE
0
1
0.00
1.00
-1.16
-1.16
0.49
0.93
1.04
RP
0
1
0.00
1.00
-0.76
-0.76
-0.76
0.85
1.92
No_ANTIBIOTICOS
0
1
0.58
0.74
0.00
0.00
0.00
1.00
2.00
Finalmente, para poder apreciar los cambios resurgidos de estos procesos que se han realizado, vamos a llamar a la función de visualización de variables para ver los cambios conseguidos en estas.
Para evaluar la posible relación entre la respuesta completa patológica (RCP) y las características de los pacientes, se emplearán análisis estadísticos adecuados a la naturaleza de cada variable. En el caso de las variables cualitativas, como el tipo de tratamiento o el estadio del tumor, se utilizarán pruebas diseñadas para comparar proporciones entre distintos grupos, como la prueba de Chi-cuadrado o, en situaciones donde el tamaño de la muestra sea reducido, la prueba exacta de Fisher. Estas herramientas permiten determinar si existen diferencias significativas en la distribución de estas características entre los pacientes que lograron o no una RCP.
Para las variables cuantitativas, como la edad del paciente o el índice de proliferación tumoral Ki67, se aplicarán pruebas que permitan evaluar diferencias en valores numéricos entre los grupos analizados. La prueba t de Student se empleará para comparar los valores promedio de estas variables entre los pacientes con y sin RCP, mientras que los coeficientes de correlación de Pearson o Spearman ayudarán a medir la intensidad y dirección de la relación entre estas características y la RCP.
A través de estos análisis se buscarán patrones o tendencias que puedan sugerir una asociación entre las características clínicas y patológicas de los pacientes y su respuesta al tratamiento. Los resultados obtenidos contribuirán a una mejor comprensión de los factores que podrían influir en la probabilidad de alcanzar una RCP, proporcionando información valiosa para optimizar estrategias terapéuticas y mejorar la toma de decisiones clínicas.
Explicación teórica
Antes de comenzar con el análisis estadístico, es fundamental comprender qué tipo de variables tenemos y cómo tratarlas según su naturaleza. Las técnicas estadísticas que se aplican varían dependiendo de si las variables son categóricas o numéricas.
Relación entre dos variables categóricas
Para analizar la relación entre dos variables categóricas, se comienza generando una tabla de contingencia, que nos muestra cuántas observaciones hay en cada combinación de categorías.
Dependiendo del número de observaciones en las celdas de la tabla, se elige uno de estos tests:
Si algún valor < 5 → Test de Fisher
Si todos los valores ≥ 5 → Test Chi-Cuadrado
Luego, se interpreta el resultado a través del p-valor:
Interpretación del p-valor
Si p < 0.05, se rechaza la hipótesis nula → Existe asociación estadística entre las variables.
Si p ≥ 0.05, no se rechaza la hipótesis nula → No hay evidencia de asociación.
Relación entre una variable categórica y una numérica
En este caso, el tipo de test dependerá de si la variable numérica sigue una distribución normal. Esto se evalúa con el test de Shapiro-Wilk:
Si p < 0.05 → No hay normalidad → Test de Wilcoxon
Si p ≥ 0.05 → Hay normalidad → Test t de Student
Nuevamente, el resultado se interpreta con el p-valor del test:
¿Existe asociación?
Si p < 0.05, se detecta una diferencia significativa entre los grupos.
Si p ≥ 0.05, no hay evidencia estadística de diferencia.
Relación entre dos variables numéricas
Cuando ambas variables son numéricas, se verifica su distribución con el test de Shapiro-Wilk. En función de los resultados, se selecciona el test de correlación apropiado:
Si ambas variables NO son normales → Correlación de Spearman
Si ambas variables son normales → Correlación de Pearson
Importante
Para aplicar el test de Pearson, ambas variables deben seguir distribución normal. Es decir, ambas deben tener p ≥ 0.05 en el test de Shapiro-Wilk.
Finalmente, el p-valor del test de correlación nos indicará si existe una relación estadísticamente significativa entre ambas variables.
 Analizando relación entre RCP y EDAD_DIAGNOSTICO
(Variable categórica)
Test de Fisher p-value: 0.0335
Existe asociación estadística entre las variables.
 Analizando relación entre RCP y ESTADO_MENOPAUSICO
(Variable categórica)
Test Chi-cuadrado p-value: 0.1172
No existe asociación estadística entre las variables.
 Analizando relación entre RCP y ESTADO_MENOPAUSICO
(Variable categórica)
Test Chi-cuadrado p-value: 0.1172
No existe asociación estadística entre las variables.
 Analizando relación entre RCP y TIPO_CIRUGIA
(Variable categórica)
Test Chi-cuadrado p-value: 0.8977
No existe asociación estadística entre las variables.
## Warning in cor.test.default(data[[variable]],
## as.numeric(as.factor(data[[evento]])), : Cannot compute exact p-value with ties
 Analizando relación entre RCP y RE
(Variable numérica)
Shapiro-Wilk p-value: 0
Correlación spearman p-value: 0
Existe asociación estadística entre las variables.
## Warning in cor.test.default(data[[variable]],
## as.numeric(as.factor(data[[evento]])), : Cannot compute exact p-value with ties
 Analizando relación entre RCP y RP
(Variable numérica)
Shapiro-Wilk p-value: 0
Correlación spearman p-value: 3e-04
Existe asociación estadística entre las variables.
 Analizando relación entre RCP y GRADO_CAT
(Variable categórica)
Test Chi-cuadrado p-value: 0.2633
No existe asociación estadística entre las variables.
 Analizando relación entre RCP y HISTOLOGIA_CAT
(Variable categórica)
Test Chi-cuadrado p-value: 0.195
No existe asociación estadística entre las variables.
## Warning in chisq.test(tabla): Chi-squared approximation may be incorrect
 Analizando relación entre RCP y ESTADIO_CAT
(Variable categórica)
Test Chi-cuadrado p-value: 0.5603
No existe asociación estadística entre las variables.
 Analizando relación entre RCP y No_ANTIBIOTICOS_CAT
(Variable categórica)
Test Chi-cuadrado p-value: 1
No existe asociación estadística entre las variables.
Interpretaciones
Tras el estudio, se han comprobado que de las 16 variables analizadas, solamente la mitad constituye el grupo de variables con mayor evidencia estadística. Entre estas encontramos FENOTIPO_IHQ_CAT, HT_ADY_OK, QT_CAT, RE…
Por otro lado, en el grupo que incluye a las variables que no parecen presentar relación significativa con la variable evento están TIPO_CIRUGIA, GRADO_CAT, ESTADO_MENOPAUSICO, No_ANTIBIOTICOS_CAT…
Es cierto que estos resultados pueden verse perjudicados por el uso de Fisher (simulado) dado que suponía mucho esfuerzo para el equipo y el programa el realizar el test completo. Por ende, aquellas variables que se consideren convenientes van a ser utilizadas para el análisis multivariante.
Tabla 2. Variables sin asociación estadísticamente significativa con RCP.
Variable
Tipo
Test.estadístico
p.valor
Comentario
No_ANTIBIOTICOS_CAT
Categórica
Chi-cuadrado
1
Sin asociación alguna
TIPO_CIRUGIA
Categórica
Fisher
0.884
Muy baja asociación
ESTADIO_CAT
Categórica
Chi-cuadrado
0.560
Baja
Tn
Categórica
Chi-cuadrado
0.411
Baja
Nx
Categórica
Fisher
0.137
Baja
ESTADO_MENOPAUSICO
Categórica
Fisher
0.103
Ligeramente no significativa
GRADO_CAT
Categórica
Chi-cuadrado
0.263
No significativa
HISTOLOGIA_CAT
Categórica
Chi-cuadrado
0.195
No significativa
Análisis multivariante
Se utilizarán métodos estadísticos avanzados para analizar cómo se relacionan varias variables entre sí y cuáles de ellas tienen mayor influencia sobre la probabilidad de que ocurra una respuesta completa patológica (RCP). En particular, se aplicará la regresión logística, una técnica que permite predecir la probabilidad de que ocurra un evento (en este caso, la RCP) a partir de otras variables. Luego, se evaluará la importancia de cada una de estas variables en el modelo, analizando factores como la significancia de los coeficientes (qué tan fuertes son las relaciones) y la calidad del modelo en general para ver cuán bien está prediciendo la RCP.
Explicación teórica
Con el objetivo de construir modelos que sean eficientes, interpretables y clínicamente relevantes, se implementarán técnicas de selección automática de variables. Estas técnicas permiten identificar un subconjunto óptimo de predictores basado en su contribución al modelo y a la explicación del evento RCP.
Técnicas de Selección Automática
Se utilizarán tres enfoques clásicos:
Selección hacia adelante (Forward Selection)
Parte de un modelo vacío e incorpora variables una por una, eligiendo en cada paso aquella que más mejora el modelo (según un criterio como AIC o BIC).
Ventaja: útil cuando hay muchas variables y se busca simplicidad.
Selección hacia atrás (Backward Elimination)
Parte de un modelo completo (con todas las variables) y elimina progresivamente las variables menos útiles.
Ventaja: considera la interacción total de las variables desde el inicio.
Selección bidireccional (Stepwise)
Combina ambos métodos: puede añadir o quitar variables en cada paso, dependiendo de si mejoran o no el modelo.
Ventaja: más flexible y generalmente logra modelos equilibrados.
Aplicación a Distintos Conjuntos de Variables
Para comprender cómo influyen las distintas variables en el modelo y validar el valor predictivo de la información seleccionada previamente, se aplicarán los métodos de selección automática a tres conjuntos de variables:
Modelo A: Variables Signficativas
Solo incluye aquellas variables que, en el análisis previo, mostraron una asociación estadísticamente significativa con `RCP`.
Objetivo: construir un modelo compacto y eficaz.
Modelo B: Variables no Significativas
Incluye únicamente las variables que no mostraron asociación estadística, pero se evaluará si pueden aportar valor en conjunto.
Objetivo: explorar posibles efectos combinados o no evidentes en análisis univariantes.
Modelo C: Todas las Variables
Considera todas las variables, independientemente de su significancia previa.
Objetivo: comparar el rendimiento del modelo global frente a los anteriores y verificar si hay variables descartadas prematuramente que son útiles.
Evaluación del Modelo
Cada modelo se evaluará en función de:
Criterios de información (AIC / BIC).
Calidad del ajuste (pseudo-R², estadísticos de bondad de ajuste).
Interpretabilidad clínica y parsimonia del modelo.
La comparación de los tres modelos permitirá determinar no solo qué variables resultan más útiles, sino también cómo influye la selección previa basada en pruebas de significancia en la calidad del modelo final.
Aplicación teórica
A continuación se dara la selección de variables para cada uno de los modelos predefinidos.
# FILTRADO DEL DATASETsignificativas <-subset(dataset_recodificado, select =c(FENOTIPO_IHQ_CAT, HT_ADY_OK, QT_CAT, RE, RP, Ki67_CAT, EDAD_DIAGNOSTICO, TAMAÑO, RCP))significativas <-na.omit(significativas)# CREACION DE MODELOSmod_completo <-glm((RCP=="SI")*1~ ., data = significativas, family =binomial("logit"))mod_basico <-glm((RCP=="SI")*1~1, data = significativas, family =binomial("logit"))# APLICACIÓN DEL AJUSTEmodA_forward <-stepAIC(mod_basico, direction ="forward", scope=list(lower=mod_basico,upper=~FENOTIPO_IHQ_CAT+HT_ADY_OK+QT_CAT+RE+ RP+Ki67_CAT+EDAD_DIAGNOSTICO+TAMAÑO))
# FILTRADO DEL DATASETsignificativas <-subset(dataset_recodificado, select =c(FENOTIPO_IHQ_CAT, HT_ADY_OK, QT_CAT, RE, RP, Ki67_CAT, EDAD_DIAGNOSTICO, TAMAÑO, RCP))significativas <-na.omit(significativas)# CREACION DE MODELOSmod_completo <-glm((RCP=="SI")*1~ ., data = significativas, family =binomial("logit"))mod_basico <-glm((RCP=="SI")*1~1, data = significativas, family =binomial("logit"))# APLICACIÓN DEL AJUSTEmodA_backward <-stepAIC(mod_completo, direction ="backward", scope=list(lower=mod_basico,upper=~FENOTIPO_IHQ_CAT+HT_ADY_OK+QT_CAT+RE+ RP+Ki67_CAT+EDAD_DIAGNOSTICO+TAMAÑO))
# FILTRADO DEL DATASETsignificativas <-subset(dataset_recodificado, select =c(FENOTIPO_IHQ_CAT, HT_ADY_OK, QT_CAT, RE, RP, Ki67_CAT, EDAD_DIAGNOSTICO, TAMAÑO, RCP))significativas <-na.omit(significativas)# CREACION DE MODELOSmod_completo <-glm((RCP=="SI")*1~ ., data = significativas, family =binomial("logit"))mod_basico <-glm((RCP=="SI")*1~1, data = significativas, family =binomial("logit"))# APLICACIÓN DEL AJUSTEmodA_both <-stepAIC(mod_completo, direction ="both")
# FILTRADO DEL DATASETno_significativas <-subset(dataset_recodificado, select =c(No_ANTIBIOTICOS_CAT, TIPO_CIRUGIA, ESTADIO_CAT, Tn, Nx, ESTADO_MENOPAUSICO, GRADO_CAT, HISTOLOGIA_CAT, RCP))no_significativas <-na.omit(no_significativas)# CREACION DE MODELOSmod_completo <-glm((RCP=="SI")*1~ ., data = no_significativas, family =binomial("logit"))mod_basico <-glm((RCP=="SI")*1~1, data = no_significativas, family =binomial("logit"))# APLICACIÓN DEL AJUSTEmodB_both <-stepAIC(mod_completo, direction ="both")
con idénticos valores estadísticos en los 3 modelos de selección, lo que sugiere una alta estabilidad del proceso de selección.
Métrica
Valor
AIC
228.7
Residual deviance
202.70
Iteraciones
13
Los resultados del modelo sugieren que el fenotipo tumoral, el uso (o no) de hormonoterapia adyuvante, el tamaño tumoral, la expresión de receptores de progesterona (RP) y el índice de proliferación (Ki67) tienen un impacto relevante sobre la probabilidad de alcanzar una respuesta completa patológica (RCP).
En particular, el fenotipo triple negativo se asocia significativamente con una menor probabilidad de RCP. Aunque esto puede parecer contraintuitivo dependiendo del esquema de tratamiento, es coherente con la alta heterogeneidad biológica de este subtipo.
Por otro lado, no recibir hormonoterapia adyuvante se relaciona con una mayor probabilidad de RCP. Esto probablemente actúa como un indicador indirecto de subtipos tumorales más agresivos, como el triple negativo, que suelen ser más sensibles a la quimioterapia pero no hormonodependientes.
Modelo B
Para el modelo B cuya fórmula final es
RCP ~ ESTADIO_CAT + Nx + GRADO_CAT
Métrica
Valor
AIC
122.42
Residual deviance
108.42
Iteraciones
15
En los tres enfoques de selección de variables para el Modelo B (forward, backward y stepwise), la variable GRADO_CAT3 (probablemente grado histológico 3) aparece consistentemente como un factor significativamente asociado a la probabilidad de respuesta completa patológica (RCP), con un efecto positivo.
En los modelos backward y stepwise (idénticos en este caso), también se identifica como significativa la categoría Nx2 (clasificación ganglionar), que se asocia negativamente con la RCP. El valor extremo y no significativo de Nx3 sugiere un bajo número de casos o posible colinealidad.
El modelo forward es más simple, incluyendo solo GRADO_CAT3, con mejor parsimonia pero menor ajuste. Los modelos backward y stepwise incorporan más variables, logrando un menor deviance residual aunque con mayor AIC.
En los tres enfoques de selección de variables para el modelo C, la variable Ki67_CAT>14 (indicador de alta proliferación celular) aparece de manera consistente, aunque no es significativa en ninguno de los modelos, probablemente debido a alta varianza.
En el modelo forward, el receptor de estrógenos (RE) muestra una asociación negativa significativa con la probabilidad de respuesta completa patológica (RCP), mientras que ciertos esquemas de quimioterapia (QT_CATNO antiHER2) también presentan significación.
En los modelos backward y stepwise, se observa una asociación negativa significativa de la categoría Nx2 (afectación ganglionar) con la RCP. Además, el fenotipo triple negativo (FENOTIPO_IHQ_CATTRIPLE NEGATIVO) se asocia significativamente de forma negativa con la RCP, lo cual es coherente con su comportamiento clínico más agresivo.
La variable TAMAÑO del tumor también muestra una tendencia negativa marginalmente significativa (p ≈ 0.052), lo que podría indicar que tumores más grandes tienen menos probabilidad de lograr RCP.
Aunque el modelo forward es más parsimonioso (menos variables y menor AIC), los modelos backward y stepwise logran mejor ajuste (menor deviance residual), incorporando múltiples predictores clínicamente relevantes.
Predicciones
Teniendo en cuenta los valores de AIC como método de evaluación inicial consideramos que los modelos conseguidos para el modelo C son los mejores para poder realizar predicciones y, por ende, vamos a utilizar ambos.
## Paciente 3 - Probabilidad: 0.826 - Predicción: SI - RCP = SI
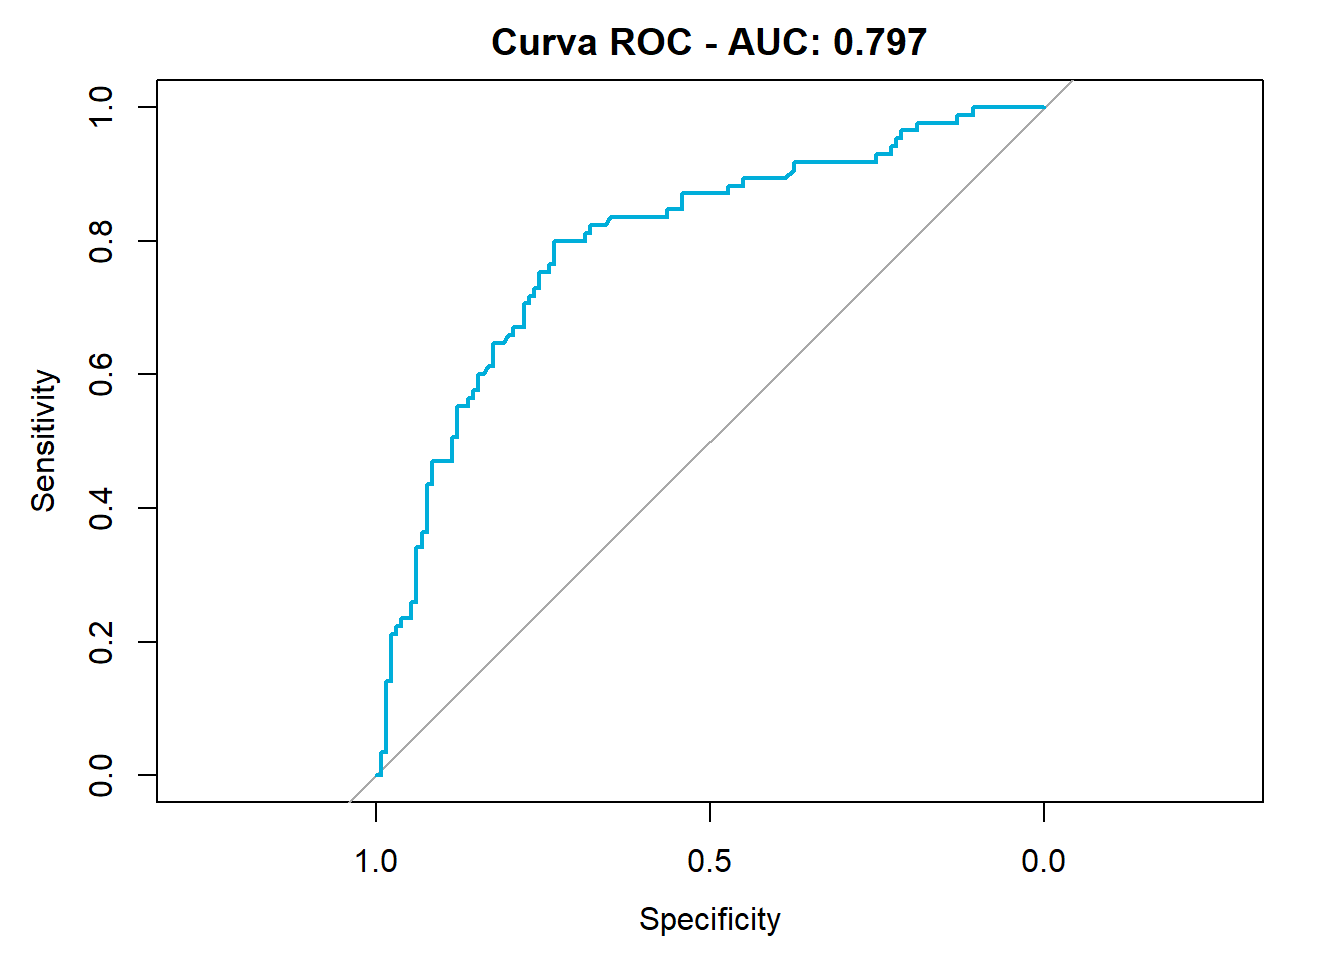
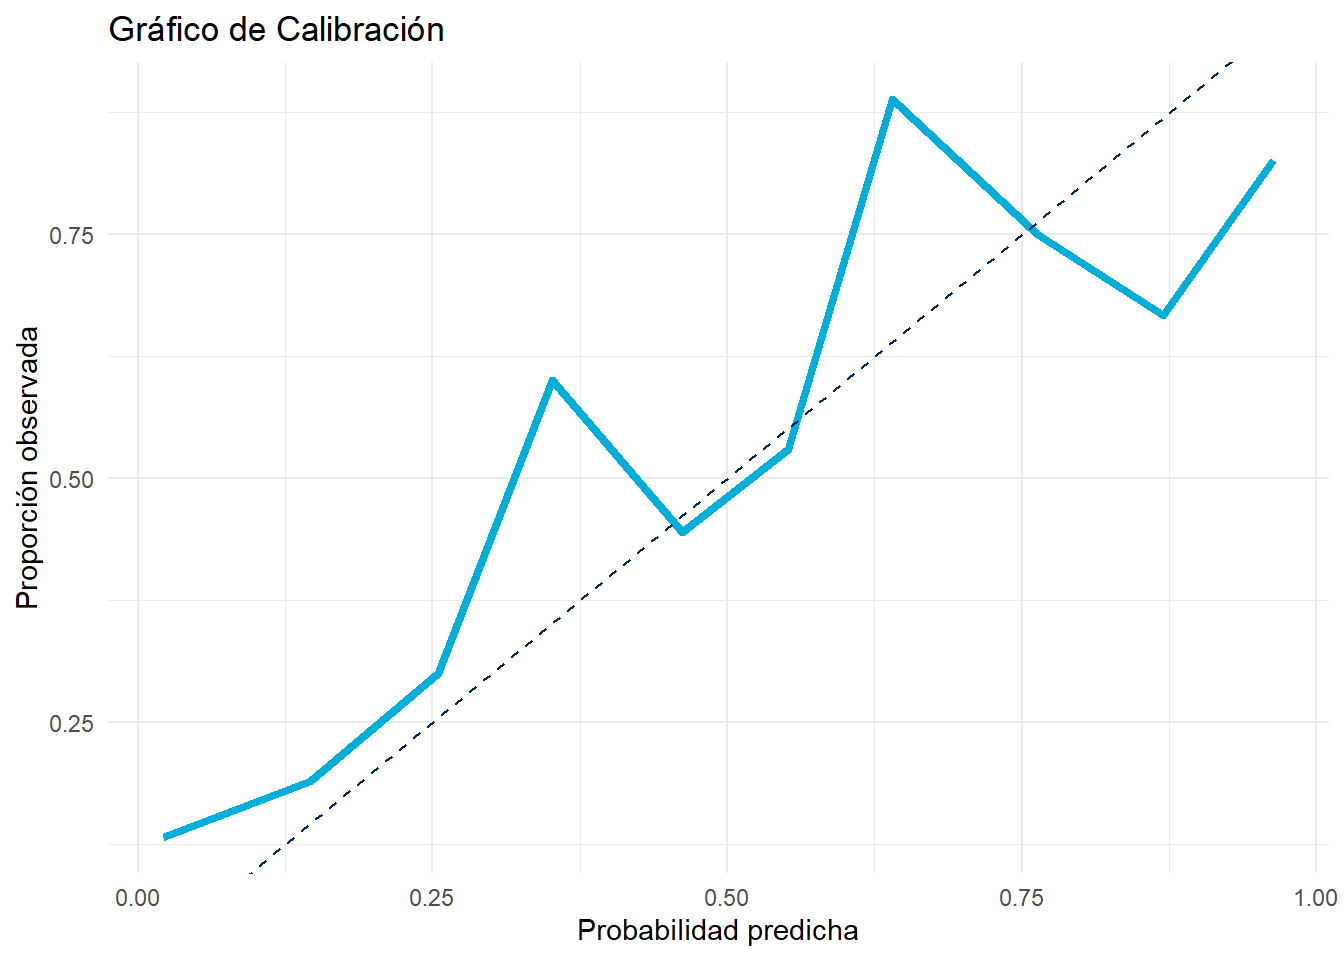
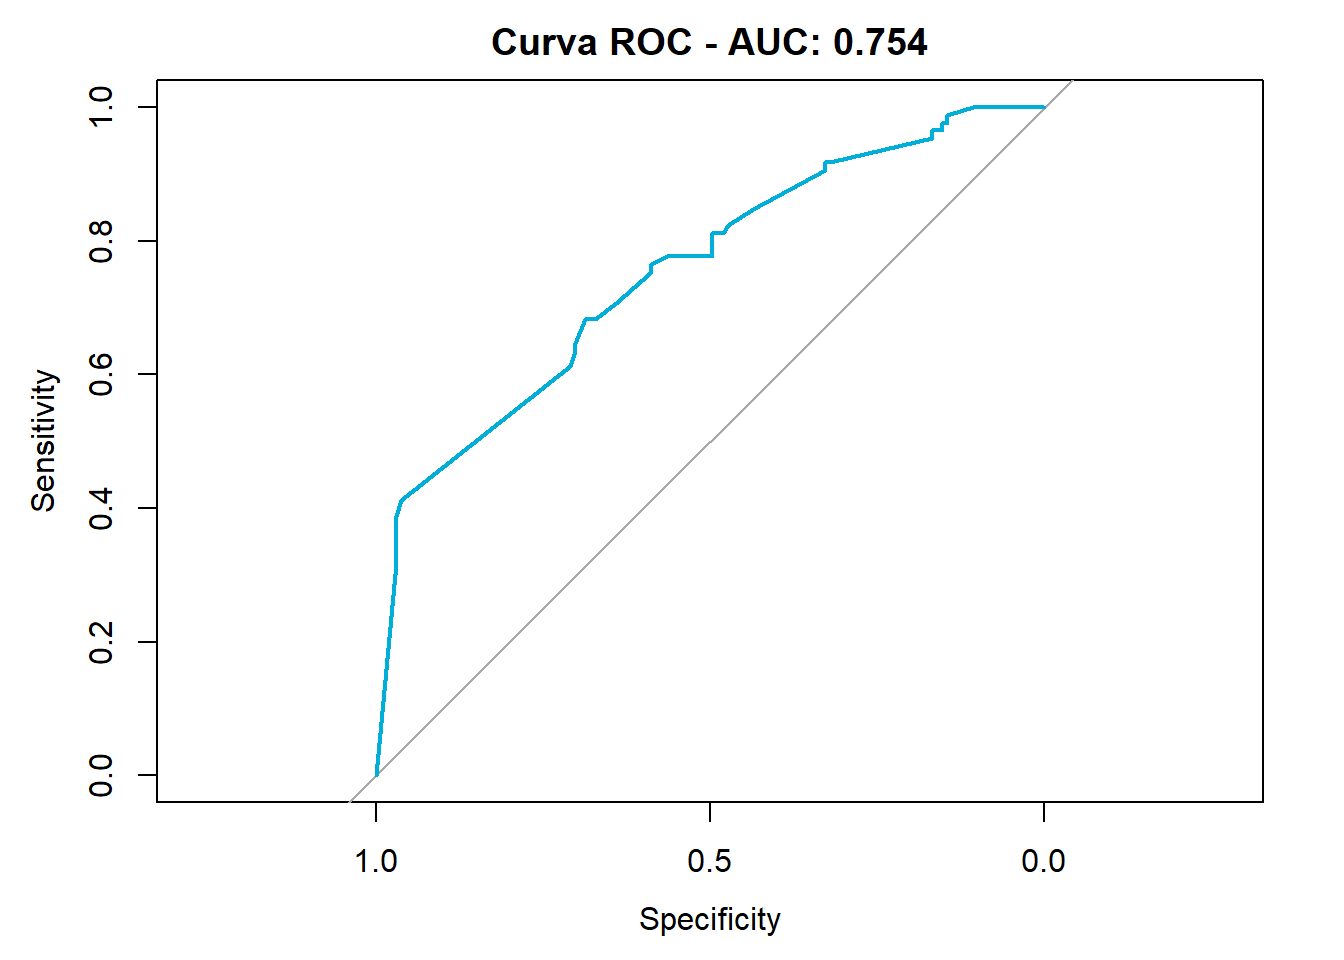
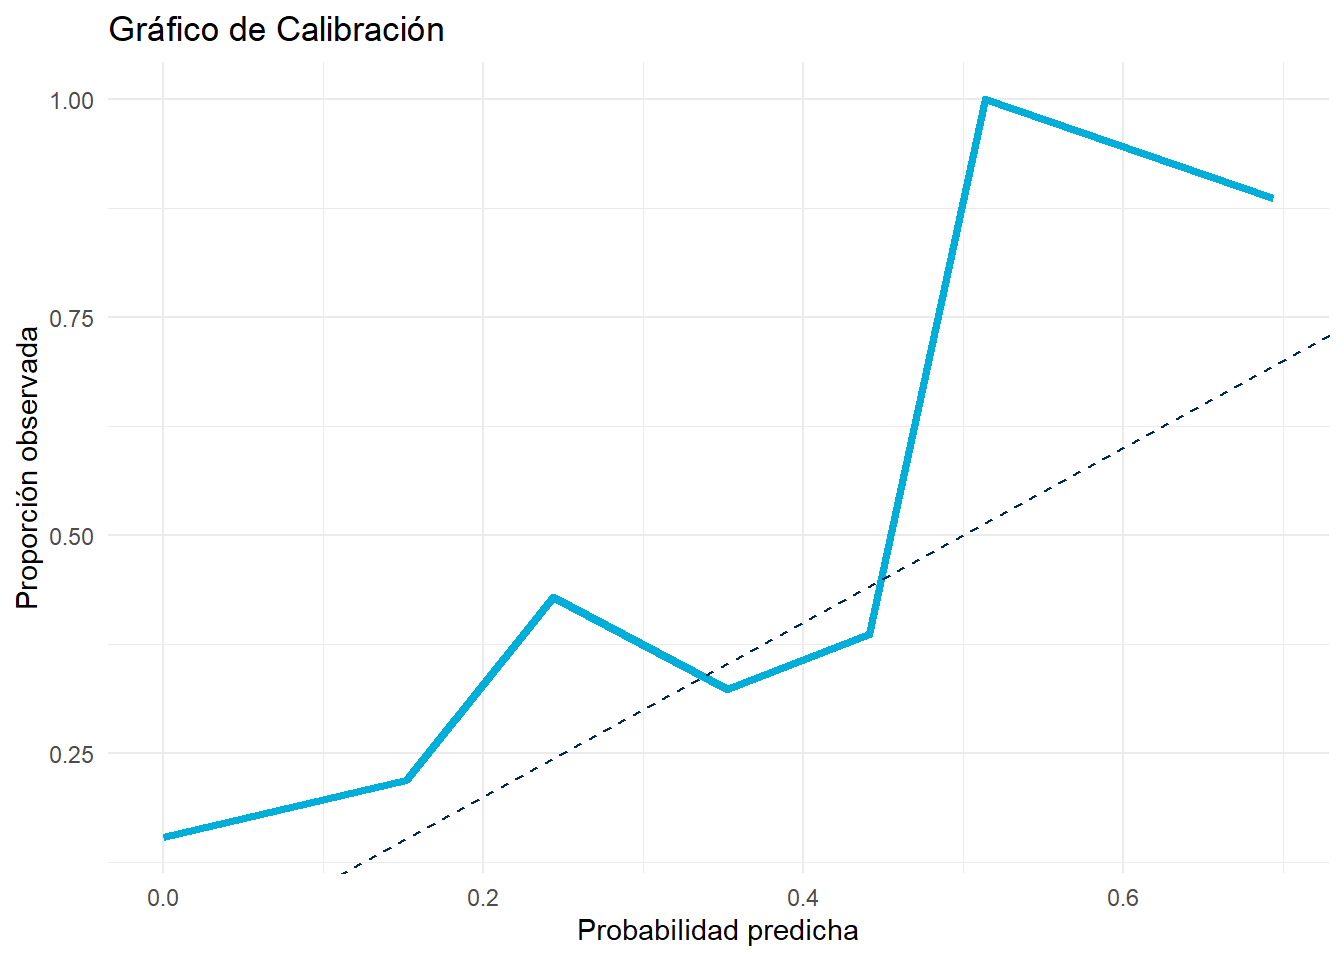
Vamos a evaluar este modelo a través de la curva ROC que nos permite medir la capacidad del modelo para discriminar entre pacientes con y sin RCP. Por otro lado, con el gráfico de calibración evaluamos si las probabilidades predichas por el modelo coinciden con las frecuencias observadas.
## Setting levels: control = NO, case = SI
## Setting direction: controls < cases
El modelo presenta un buen rendimiento discriminativo, con un AUC de 0.797, lo que indica una capacidad adecuada para distinguir entre pacientes con y sin el evento de interés. La curva ROC se aleja claramente de la diagonal, lo que refuerza esta buena discriminación.
En cuanto a la calibración, el gráfico muestra que las probabilidades predichas están bastante alineadas con las observadas, aunque hay cierta desviación en los extremos. En general, el modelo tiende a predecir bien las probabilidades reales, lo cual respalda la validez de las predicciones realizadas, incluyendo los ejemplos concretos evaluados.
## Setting levels: control = NO, case = SI
## Setting direction: controls < cases
Este modelo también presenta un rendimiento razonable, con un AUC de 0.754, aunque ligeramente inferior al del modelo anterior. La capacidad discriminativa sigue siendo aceptable.
Sin embargo, el gráfico de calibración revela una menor concordancia entre las probabilidades predichas y las observadas, especialmente en los rangos intermedios y altos, donde el modelo tiende a sobreestimar el riesgo. A pesar de ello, las predicciones realizadas en los ejemplos fueron correctas, lo que sugiere que, aunque la calibración global es mejorable, puede ofrecer resultados útiles a nivel individual.
Análisis de supervivencia
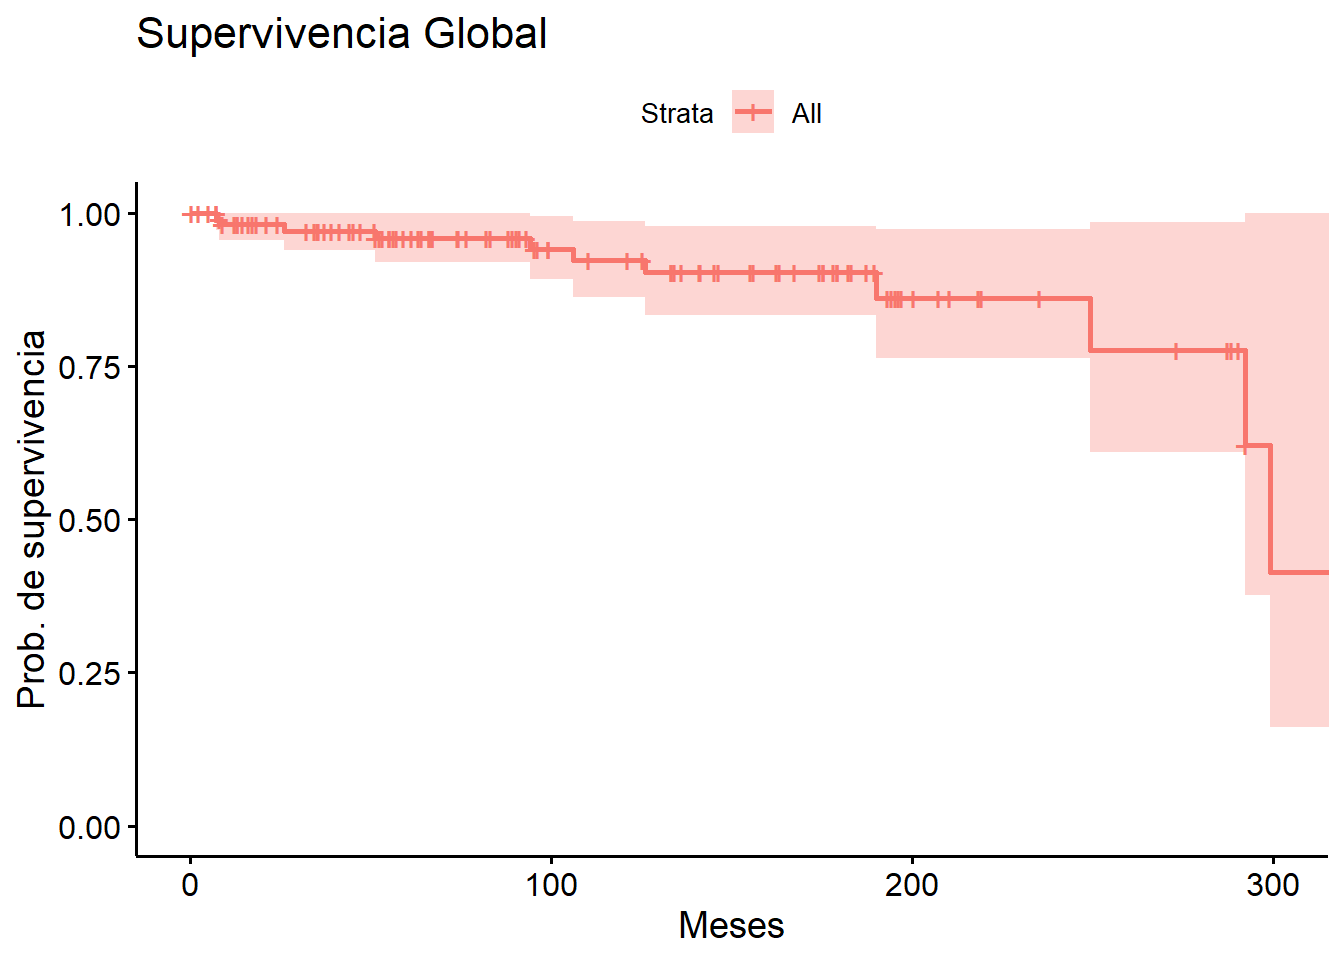
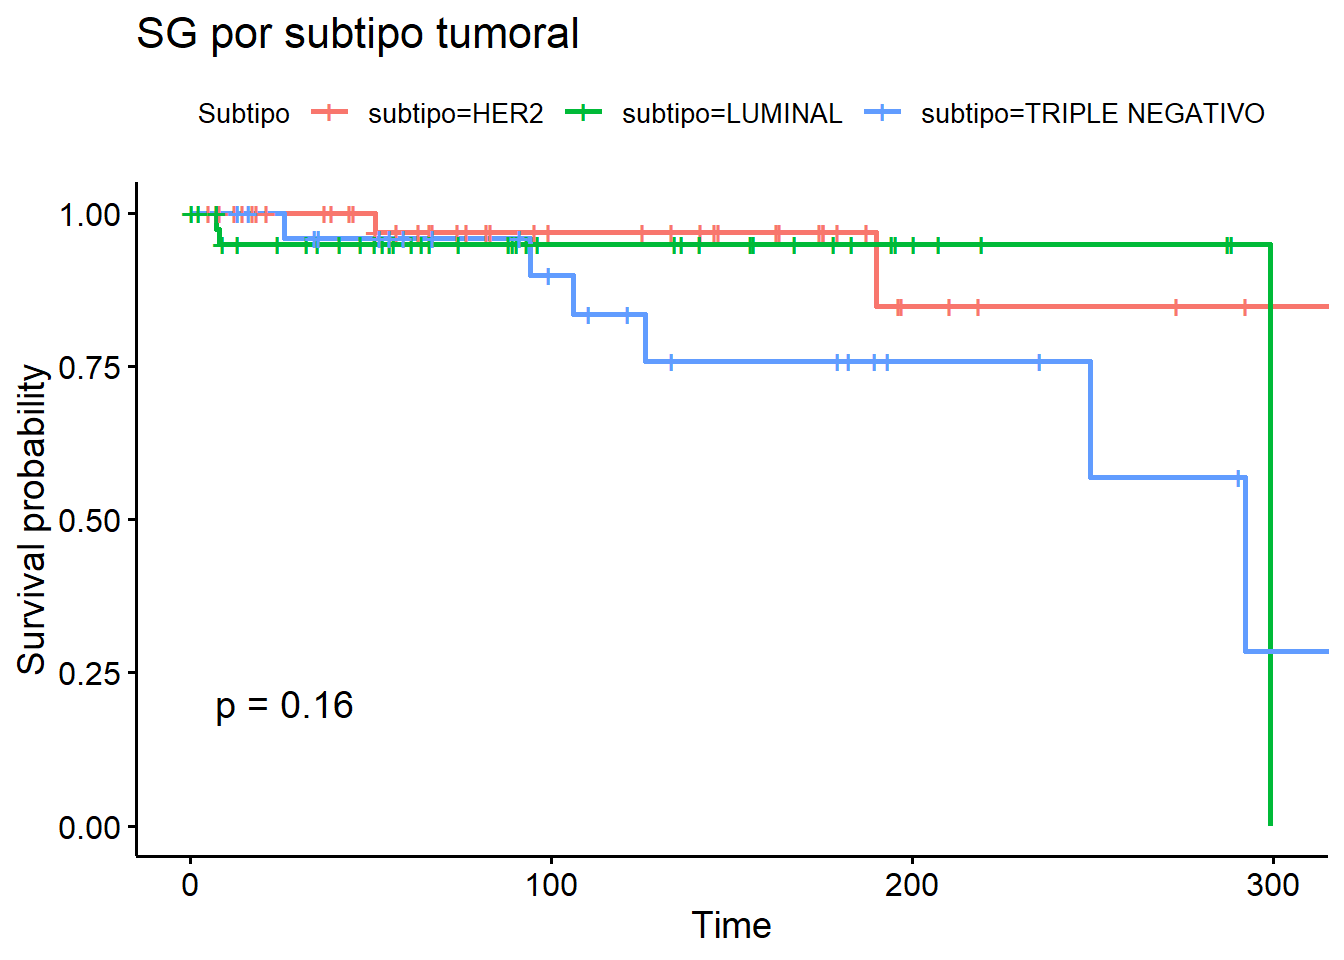
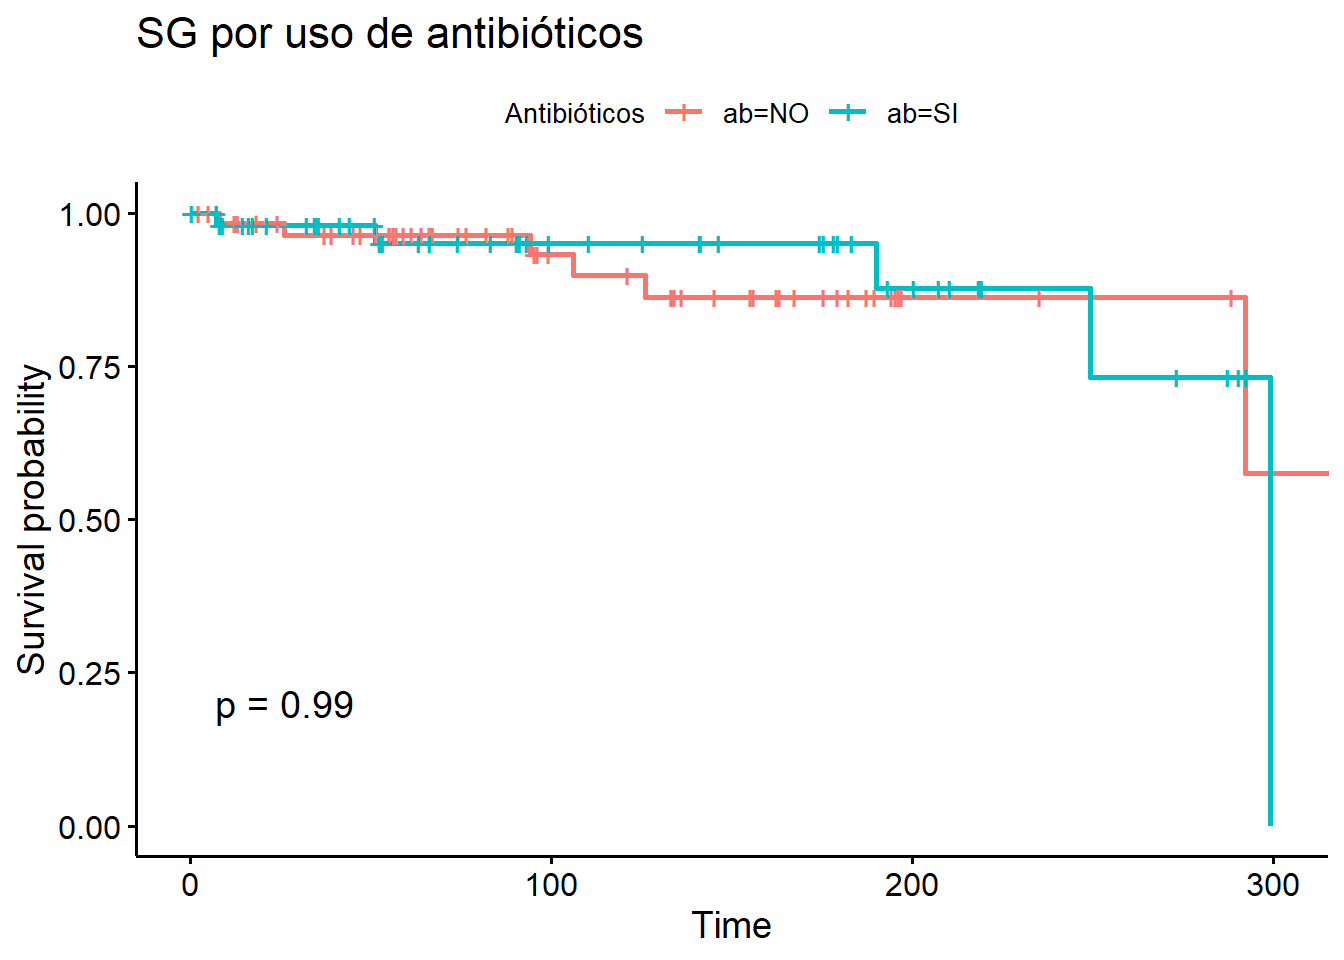
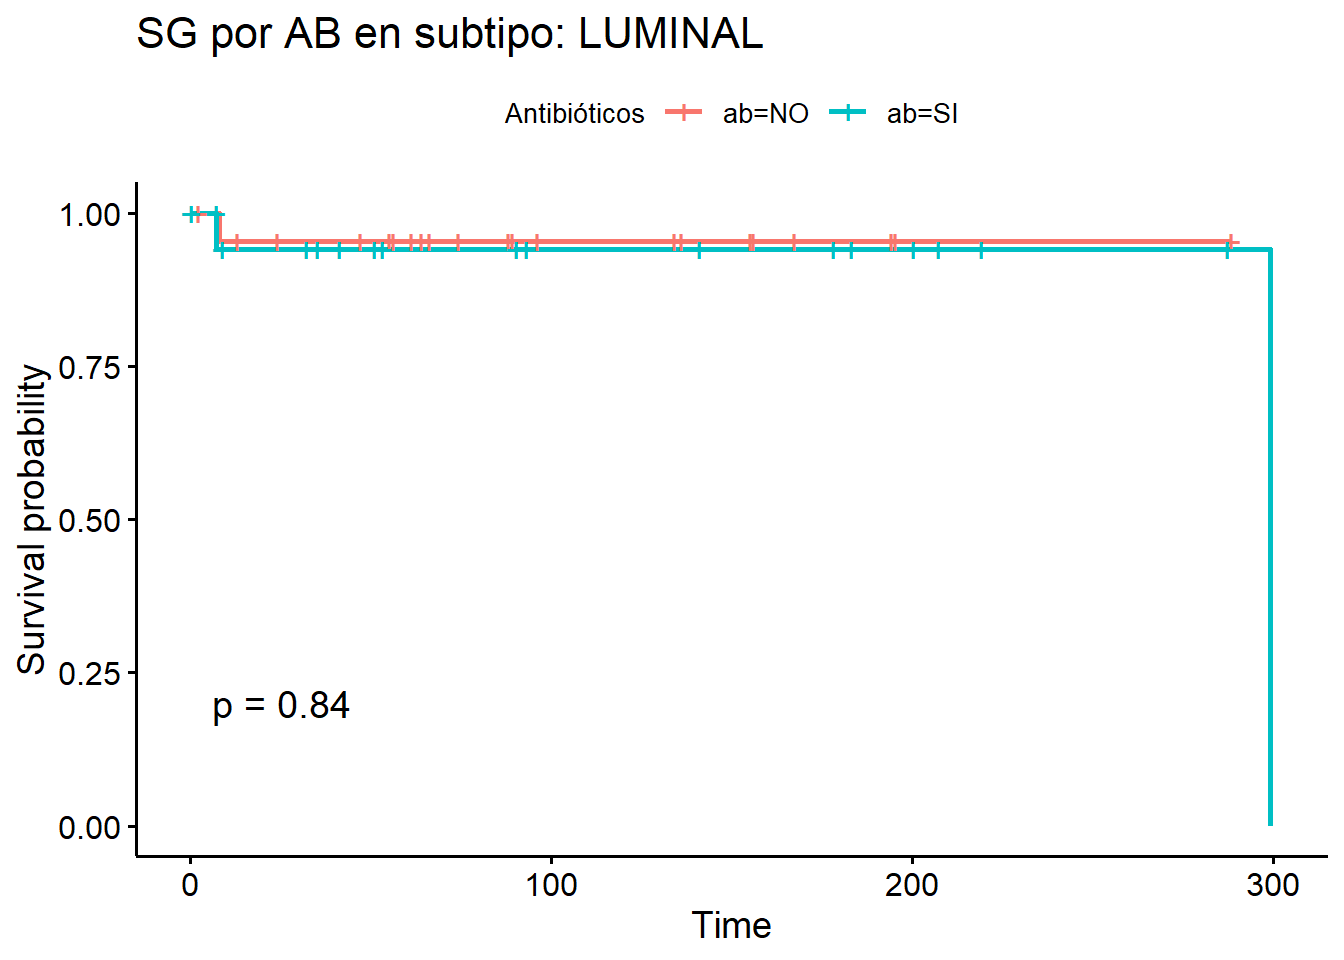
Se llevó a cabo un análisis de supervivencia global (SG) con el objetivo de evaluar el impacto del uso de antibióticos en pacientes con cáncer de mama tratadas con quimioterapia neoadyuvante. El tiempo de seguimiento se calculó como la diferencia en meses entre la fecha de inicio del tratamiento (FECHA_INICIO_QT) y la fecha del último control (FECHA_ULTIMO_CONTROL). El evento de interés se definió como el fallecimiento de la paciente, codificado a partir de la variable ESTADO_ULTIMO_CONTROL (estado_SG = 1 si el estado es “MCE”, y 0 en caso contrario). Se estimaron curvas de Kaplan-Meier para evaluar la supervivencia global en el total de pacientes y se compararon las curvas según los subtipos moleculares del tumor (Luminal, HER2+, Triple Negativo), así como según el uso de antibióticos durante el tratamiento. Para evaluar diferencias estadísticas entre grupos se aplicó el test de log-rank. Finalmente, se repitió el análisis de supervivencia estratificado por subtipo molecular, comparando dentro de cada subtipo a las pacientes que recibieron antibióticos frente a las que no, con el fin de explorar si el efecto de los antibióticos sobre la supervivencia varía según el tipo biológico del cáncer.
Código
# Preparar los datosdatos_preparados <-preparar_datos_supervivencia(dataset_recodificado)# Ejecutar el análisisresultados_sg <-analisis_supervivencia(datos_preparados)# Mostrar los gráficosresultados_sg$global
La probabilidad de supervivencia en la cohorte disminuye de manera progresiva y acentuada, especialmente a partir de los 270 meses de seguimiento, mostrando una tendencia que se aproxima a un descenso exponencial. Sin embargo, entre los 100 y 200 meses, la probabilidad aún se mantiene relativamente alta, oscilando entre 1 y 0.75.
Código
resultados_sg$por_subtipo
En el análisis por subtipos moleculares, las pacientes con tumores Luminal experimentan una disminución brusca en la probabilidad de supervivencia alrededor de los 300 meses. En contraste, el subtipo HER2+ mantiene una probabilidad de supervivencia elevada, con valores que permanecen entre 1 y 0.75 a lo largo del tiempo analizado. Por su parte, el subtipo Triple Negativo muestra una caída más pronunciada en la probabilidad a partir de los 100 meses, aunque esta se mantiene por encima de 0.75 hasta aproximadamente los 250 meses, momento en el que desciende hasta 0.5 y alcanza un valor ligeramente superior a 0.25 en torno a los 300 meses.
Código
resultados_sg$por_ab
En cuanto al uso de antibióticos, se observa que las pacientes que no recibieron antibióticos mantienen una probabilidad de supervivencia relativamente estable, que no desciende por debajo de 0.6 durante el período de seguimiento. En cambio, aquellas que sí recibieron antibióticos presentan una disminución gradual en la probabilidad de supervivencia, que se acentúa cerca de los 300 meses, momento en el cual la probabilidad cae bruscamente hasta alcanzar un valor próximo a 0.
Código
resultados_sg$por_subtipo_y_ab[["LUMINAL"]]
Al analizar específicamente el subtipo LUMINAL, se observa que las pacientes que no recibieron antibióticos presentan una probabilidad de supervivencia muy similar a la de aquellas que sí los recibieron, manteniéndose ambas ligeramente por debajo de 1 a lo largo de los 300 meses de seguimiento.
Código
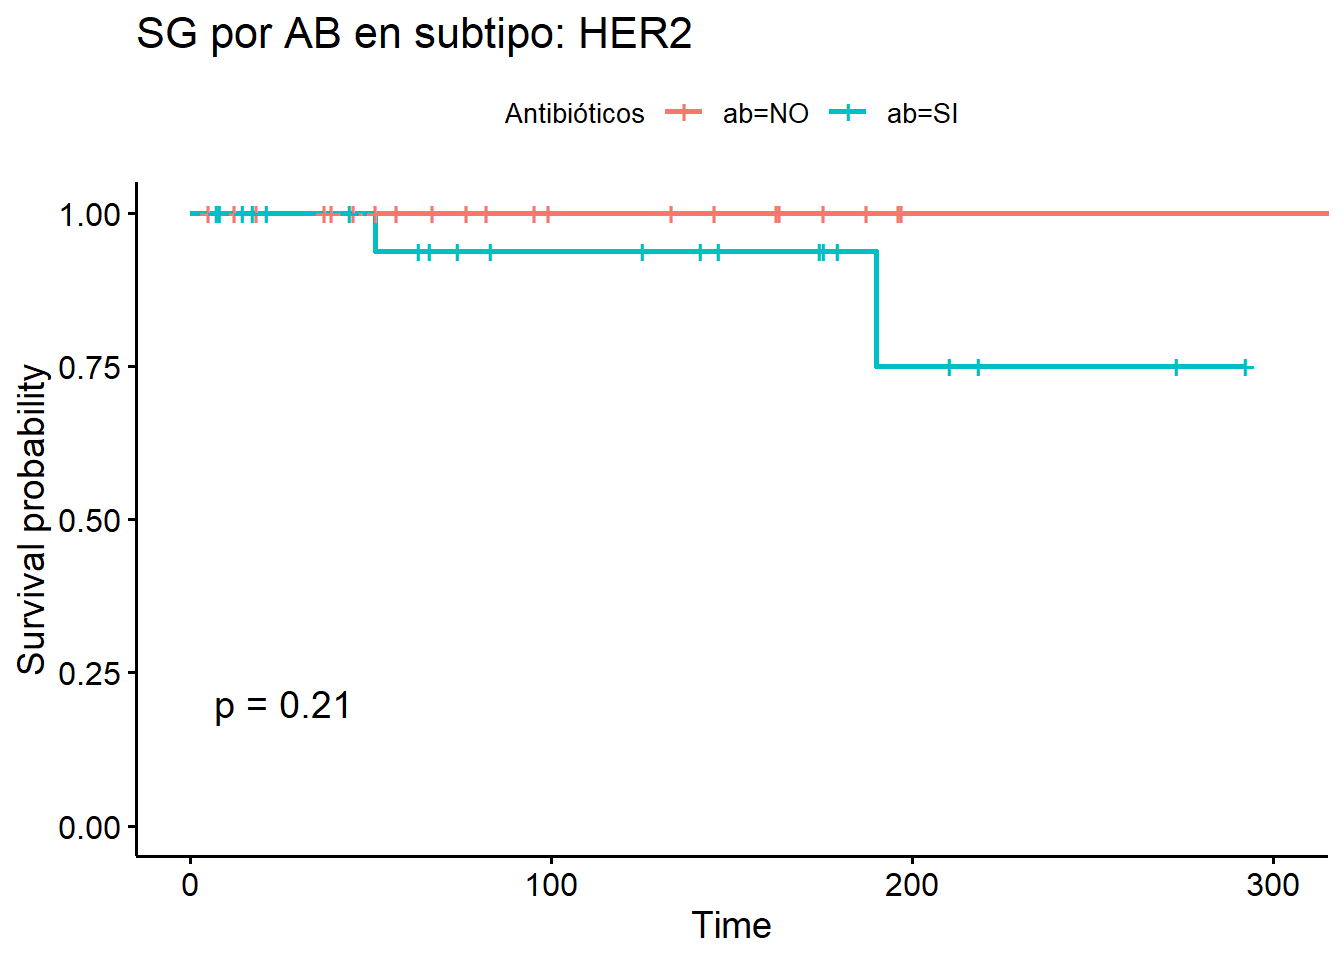
resultados_sg$por_subtipo_y_ab[["HER2"]]
Al analizar específicamente el subtipo HER2+, se observa que las pacientes que no fueron tratadas con antibióticos mantienen una probabilidad de supervivencia constante de 1 durante todo el seguimiento. Por otro lado, aquellas que sí recibieron antibióticos muestran una probabilidad algo menor, situándose por encima de 0.75 antes de los 200 meses y manteniéndose estable en torno a 0.75 a partir de ese punto.
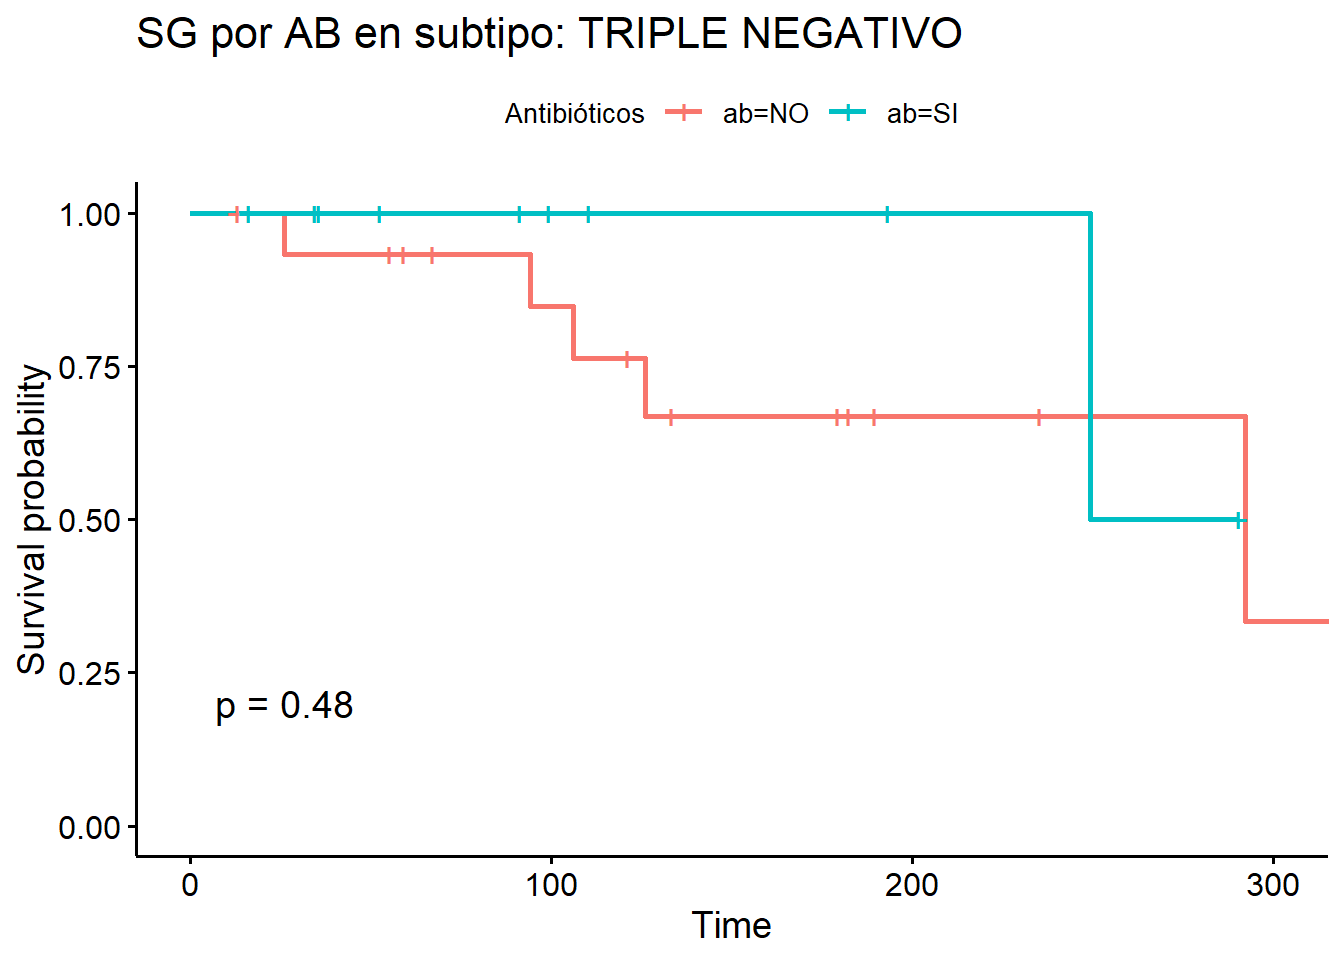
Al analizar específicamente el subtipo TRIPLENEGATIVO, se observa que las pacientes que no recibieron antibióticos presentan una menor probabilidad de supervivencia en comparación con aquellas que sí los recibieron. En este último grupo, la probabilidad de supervivencia se mantiene en 1 hasta aproximadamente los 250 meses de seguimiento. Esto podría sugerir un posible efecto beneficioso del uso de antibióticos en pacientes con este subtipo tumoral, contribuyendo a una mayor supervivencia.
Conclusiones
Los resultados obtenidos en este análisis de supervivencia sugieren que el uso de antibióticos durante el tratamiento con quimioterapia neoadyuvante podría estar asociado a una menor probabilidad de supervivencia en pacientes con cáncer de mama, particularmente en ciertos subtipos biológicos como HER2+ y LUMINAL. Estos hallazgos respaldan la hipótesis de que la alteración de la microbiota —posiblemente inducida por la administración de antibióticos— puede influir negativamente en la eficacia de las terapias oncológicas y, en consecuencia, en la evolución clínica de las pacientes.
En contraste, en el caso del subtipo TRIPLE NEGATIVO, se observa una tendencia opuesta: las pacientes que recibieron antibióticos presentan una mayor probabilidad de supervivencia en comparación con aquellas que no los recibieron. Este hallazgo sugiere que, en este subgrupo, el uso de antibióticos podría tener un efecto beneficioso, aunque se requiere un análisis más profundo para confirmar esta asociación y comprender los mecanismos subyacentes.Además, las diferencias observadas entre subtipos moleculares subrayan la necesidad de considerar el perfil biológico del tumor a la hora de valorar el riesgo asociado al uso de antibióticos durante el tratamiento oncológico. Esto sugiere que las decisiones clínicas relacionadas con la prescripción de antimicrobianos deberían realizarse con cautela, y en lo posible bajo un criterio de indicación estrictamente necesario, especialmente en el contexto de la quimioterapia.
Por otro lado, estos resultados también ponen de relieve la importancia de integrar el control de infecciones, la evaluación del estado inmunológico y la vigilancia de la microbiota intestinal como factores relevantes en el manejo integral de las pacientes con cáncer. En un futuro, este enfoque podría abrir la puerta a estrategias de soporte que busquen minimizar el impacto de los antibióticos o restaurar la microbiota, como el uso de probióticos o transplantes fecales, siempre dentro de un marco de evidencia científica robusta.
Finalmente, aunque este análisis no permite establecer relaciones causales definitivas, sí plantea interrogantes clínicamente relevantes que justifican la necesidad de realizar estudios prospectivos que analicen de forma más controlada el impacto de los antibióticos en la supervivencia, considerando la biología del tumor, las comorbilidades y la composición de la microbiota como posibles factores moduladores.