En esta segunda actividad, Modelado predictivo , se desarrollarán modelos para predecir la respuesta completa patológica (RCP) utilizando distintos algoritmos de aprendizaje computacional comúnmente empleados en la literatura.
En primer lugar, se construirá un modelo de regresión logística a partir de las variables más representativas obtenidas en la actividad 1. Posteriormente, se implementará el procedimiento de validación Repeated Holdout , parametrizando el número de repeticiones (n ) y la proporción de división entre datos de entrenamiento y test, con el fin de estimar la capacidad de generalización del modelo. Se analizarán los resultados mediante representaciones gráficas (histogramas, boxplots), evaluando el rendimiento promedio, la variabilidad y la sensibilidad al método de validación.
A continuación, se aplicará un algoritmo de búsqueda exhaustiva para identificar la mejor combinación de variables, considerando un esquema de validación honesta. Se utilizarán distintas métricas de evaluación —como la exactitud (ACC), precisión, recall, F1-score y AUC— según las características del conjunto de datos.
Además, se compararán los resultados obtenidos con otros algoritmos de aprendizaje automático incluidos en la guía docente, específicamente redes neuronales (RRNN), máquinas de vectores soporte (SVM) y árboles de decisión (DT). Para la selección de variables, se utilizarán enfoques de tipo filtrado y wrapper , siendo estos últimos independientes del algoritmo de aprendizaje utilizado. Se deberá implementar al menos un algoritmo wrapper (por ejemplo, búsqueda exhaustiva, forward selection u otro) que utilice el AUC como criterio para seleccionar el mejor modelo.
Por último, se aplicará el método de doble validación cruzada (5x2CV), como vimos en clase, para validar de forma honesta tanto la selección de hiperparámetros como las variables relevantes de cada modelo. El modelo más eficiente será desplegado en producción mediante una aplicación desarrollada en RShiny.
Diseño de modelo predictivo con Regresión Logística
Si bien en la Actividad 1 ya se realizó un análisis preliminar de predicciones en la Sección 5.4
Durante la Actividad 1 también se incurrió en un enfoque metodológico limitado en el proceso de selección de variables, al escoger manualmente un conjunto de predictores considerados a priori como relevantes con respecto al evento RCP. Esta estrategia redujo significativamente la capacidad de los métodos automáticos de selección tipo wrapper para evaluar el conjunto completo de predictores disponibles y construir un modelo verdaderamente optimizado. Por este motivo, se ha repetido todo el procedimiento de selección de variables, permitiendo que los algoritmos operen sobre el dataset completo y seleccionen, de manera objetiva, el subconjunto de variables con mayor valor predictivo.
Adicionalmente, con el propósito de mejorar la calidad del análisis y maximizar el desempeño de los modelos generados, se ha llevado a cabo un tratamiento de datos más riguroso. En primer lugar, se ha categorizado la variable EDAD_DIAGNOSTICO en intervalos clínicamente relevantes: 0-39, 40-49, 50-59, 60-69, 70-79 y ≥80, una práctica común en estudios epidemiológicos y clínicos para facilitar la interpretación y captar no linealidades en la relación entre edad y resultados clínicos (véase Altman, D.G. et al., 1991, BMJ , sobre categorización en modelos clínicos).
Asimismo, se ha transformado la información temporal relacionada con FECHA_DIAGNOSTICO, FECHA_ULTIMO_CONTROL y FECHA_INICIO_QT, agrupándolas en periodos decenales (2000-2009, 2010-2019 y 2020-2029). Esta recodificación permite captar patrones temporales más amplios sin introducir ruido innecesario por fechas específicas.
Por otro lado, las variables numéricas del dataset han sido normalizadas para garantizar una escala comparable entre predictores continuos, a excepción de Ki67 y No_ANTIBIOTICOS, que se utilizaron como base para procesos de recodificación categórica y no forman parte del análisis en su forma continua.
Este enfoque revisado ha permitido desarrollar modelos más robustos y comparables, optimizando la selección de variables y mejorando las condiciones del análisis predictivo.
Código
$ EDAD_DIAGNOSTICO <- cut (df_procesado$ EDAD_DIAGNOSTICO, breaks = c (- Inf , 39 , 49 , 59 ,69 ,79 , Inf ), labels = c ("0-39" , "40-49" , "50-59" , "60-69" ,"70-79" ,"≥80" ))$ EDAD_DIAGNOSTICO <- as.factor (df_procesado$ EDAD_DIAGNOSTICO)<- df_procesado %>% mutate (FECHA_DIAGNOSTICO = dmy (FECHA_DIAGNOSTICO),FECHA_DIAGNOSTICO = cut (year (FECHA_DIAGNOSTICO),breaks = seq (2000 , 2030 , by = 10 ),labels = c ("2000-2009" , "2010-2019" , "2020-2029" ),right = FALSE FECHA_DIAGNOSTICO = as.factor (FECHA_DIAGNOSTICO)<- df_procesado %>% mutate (FECHA_ULTIMO_CONTROL = dmy (FECHA_ULTIMO_CONTROL),FECHA_ULTIMO_CONTROL = cut (year (FECHA_ULTIMO_CONTROL),breaks = seq (2000 , 2030 , by = 10 ),labels = c ("2000-2009" , "2010-2019" , "2020-2029" ),right = FALSE FECHA_ULTIMO_CONTROL = as.factor (FECHA_ULTIMO_CONTROL)<- df_procesado %>% mutate (FECHA_INICIO_QT = dmy (FECHA_INICIO_QT),FECHA_INICIO_QT = cut (year (FECHA_INICIO_QT),breaks = seq (2000 , 2030 , by = 10 ),labels = c ("2000-2009" , "2010-2019" , "2020-2029" ),right = FALSE FECHA_INICIO_QT = as.factor (FECHA_INICIO_QT)<- sapply (df_procesado, is.numeric)# Excluir 'Ki67' y 'No_ANTIBIOTICOS' de la normalización <- setdiff (names (df_procesado)[numeric_vars], c ("Ki67" , "No_ANTIBIOTICOS" ))<- scale (df_procesado[, vars_a_normalizar])<- normalized_data
Código
skim (dataset_recodificado)
Data summary
Name
dataset_recodificado
Number of rows
445
Number of columns
22
_______________________
Column type frequency:
factor
19
numeric
3
________________________
Group variables
None
Variable type: factor
EDAD_DIAGNOSTICO
0
1.00
FALSE
5
40-: 138, 50-: 121, 60-: 85, 0-3: 64
ESTADO_MENOPAUSICO
0
1.00
FALSE
2
PRE: 265, MEN: 180
Tn
0
1.00
FALSE
4
2: 290, 3: 67, 1: 57, 4: 31
Nx
0
1.00
FALSE
4
1: 225, 0: 151, 2: 51, 3: 18
TIPO_CIRUGIA
0
1.00
FALSE
2
CON: 275, RAD: 170
HT_ADY_OK
0
1.00
FALSE
8
NO: 209, INH: 97, TAM: 79, TAM: 25
RETRASOS
0
1.00
FALSE
2
NO: 334, SI: 111
FECHA_ULTIMO_CONTROL
0
1.00
FALSE
2
202: 412, 201: 33
FECHA_INICIO_QT
0
1.00
FALSE
3
201: 261, 202: 181, 200: 3
FECHA_DIAGNOSTICO
0
1.00
FALSE
3
201: 269, 202: 172, 200: 4
ESTADO_ULTIMO_CONTROL
0
1.00
FALSE
4
VSE: 317, VCE: 71, MCE: 53, MSE: 4
GRADO_CAT
0
1.00
FALSE
2
3: 250, 1/2: 195
HISTOLOGIA_CAT
0
1.00
FALSE
2
DUC: 399, NO : 46
Ki67_CAT
0
1.00
FALSE
2
>14: 404, <=1: 41
FENOTIPO_IHQ_CAT
0
1.00
FALSE
3
LUM: 194, HER: 155, TRI: 96
ESTADIO_CAT
0
1.00
FALSE
3
II: 294, III: 129, I: 22
QT_CAT
2
1.00
FALSE
3
NO : 292, ant: 146, INM: 5
No_ANTIBIOTICOS_CAT
270
0.39
FALSE
2
Una: 118, Dos: 57
RCP
0
1.00
FALSE
2
NO: 247, SI: 198
Variable type: numeric
TAMAÑO
0
1
0
1
-1.92
-0.65
-0.25
0.35
2.69
▂▇▅▂▁
RE
0
1
0
1
-1.12
-1.12
0.43
0.99
1.10
▇▁▁▂▇
RP
0
1
0
1
-0.71
-0.71
-0.69
0.90
1.97
▇▁▁▁▂
Creación de modelos
Código
<- na.omit (dataset_recodificado)<- droplevels (dataset_modelo)<- glm (formula= RCP ~ ., data = dataset_modelo, family = binomial ("logit" ))
Código
<- glm (RCP ~ .,data = dataset_modelo, family = binomial ("logit" ))<- glm (RCP ~ 1 , data = dataset_modelo,family = binomial ("logit" ))<- stepAIC (mod_basico, direction = "forward" ,scope = list (lower = formula (mod_basico),upper = formula (mod_completo))
## Start:  AIC=231.97
## RCP ~ 1
##
##                         Df Deviance    AIC
## + RE                     1   210.88 214.88
## + FENOTIPO_IHQ_CAT       2   210.96 216.96
## + QT_CAT                 2   214.59 220.59
## + ESTADO_ULTIMO_CONTROL  3   216.80 224.80
## + Ki67_CAT               1   223.80 227.80
## + HT_ADY_OK              6   214.07 228.07
## + RP                     1   224.10 228.10
## + EDAD_DIAGNOSTICO       4   218.97 228.97
## + RETRASOS               1   225.27 229.27
## + GRADO_CAT              1   225.57 229.57
## + Nx                     3   222.45 230.45
## <none>                       229.97 231.97
## + No_ANTIBIOTICOS_CAT    1   228.11 232.11
## + FECHA_ULTIMO_CONTROL   1   228.75 232.75
## + FECHA_DIAGNOSTICO      1   228.91 232.91
## + TIPO_CIRUGIA           1   229.17 233.17
## + FECHA_INICIO_QT        1   229.24 233.24
## + ESTADIO_CAT            2   227.30 233.30
## + TAMAÑO                 1   229.73 233.73
## + HISTOLOGIA_CAT         1   229.83 233.83
## + ESTADO_MENOPAUSICO     1   229.96 233.96
## + Tn                     3   227.19 235.19
##
## Step:  AIC=214.88
## RCP ~ RE
##
##                         Df Deviance    AIC
## + QT_CAT                 2   190.40 198.40
## + FENOTIPO_IHQ_CAT       2   192.93 200.93
## + ESTADO_ULTIMO_CONTROL  3   194.14 204.14
## + RETRASOS               1   207.51 213.51
## + EDAD_DIAGNOSTICO       4   201.72 213.72
## <none>                       210.88 214.88
## + Ki67_CAT               1   209.38 215.38
## + ESTADIO_CAT            2   207.41 215.41
## + No_ANTIBIOTICOS_CAT    1   209.65 215.65
## + GRADO_CAT              1   210.11 216.11
## + FECHA_ULTIMO_CONTROL   1   210.18 216.18
## + Tn                     3   206.19 216.19
## + TAMAÑO                 1   210.42 216.42
## + FECHA_INICIO_QT        1   210.49 216.49
## + FECHA_DIAGNOSTICO      1   210.49 216.49
## + TIPO_CIRUGIA           1   210.54 216.54
## + HISTOLOGIA_CAT         1   210.78 216.78
## + RP                     1   210.83 216.83
## + ESTADO_MENOPAUSICO     1   210.88 216.88
## + Nx                     3   208.77 218.77
## + HT_ADY_OK              6   206.91 222.91
##
## Step:  AIC=198.4
## RCP ~ RE + QT_CAT
##
##                         Df Deviance    AIC
## + ESTADO_ULTIMO_CONTROL  3   175.36 189.36
## + EDAD_DIAGNOSTICO       4   179.32 195.32
## + RETRASOS               1   187.12 197.12
## + ESTADIO_CAT            2   186.18 198.18
## <none>                       190.40 198.40
## + No_ANTIBIOTICOS_CAT    1   189.11 199.11
## + FECHA_ULTIMO_CONTROL   1   189.18 199.18
## + Tn                     3   185.45 199.45
## + TAMAÑO                 1   189.87 199.87
## + TIPO_CIRUGIA           1   189.93 199.93
## + Nx                     3   186.00 200.00
## + FECHA_DIAGNOSTICO      1   190.05 200.05
## + FECHA_INICIO_QT        1   190.06 200.06
## + FENOTIPO_IHQ_CAT       2   188.14 200.14
## + GRADO_CAT              1   190.22 200.22
## + Ki67_CAT               1   190.31 200.31
## + RP                     1   190.39 200.39
## + HISTOLOGIA_CAT         1   190.39 200.39
## + ESTADO_MENOPAUSICO     1   190.40 200.40
## + HT_ADY_OK              6   185.78 205.78
##
## Step:  AIC=189.36
## RCP ~ RE + QT_CAT + ESTADO_ULTIMO_CONTROL
##
##                        Df Deviance    AIC
## + EDAD_DIAGNOSTICO      4   163.75 185.75
## + Tn                    3   167.66 187.66
## + RETRASOS              1   172.44 188.44
## <none>                      175.36 189.36
## + ESTADIO_CAT           2   171.95 189.95
## + TAMAÑO                1   174.20 190.20
## + No_ANTIBIOTICOS_CAT   1   174.45 190.45
## + FECHA_DIAGNOSTICO     1   174.75 190.75
## + FECHA_INICIO_QT       1   174.88 190.88
## + GRADO_CAT             1   175.04 191.04
## + FENOTIPO_IHQ_CAT      2   173.12 191.12
## + Ki67_CAT              1   175.16 191.16
## + ESTADO_MENOPAUSICO    1   175.22 191.22
## + HISTOLOGIA_CAT        1   175.26 191.26
## + RP                    1   175.32 191.32
## + FECHA_ULTIMO_CONTROL  1   175.34 191.34
## + TIPO_CIRUGIA          1   175.35 191.35
## + Nx                    3   172.88 192.88
## + HT_ADY_OK             6   168.79 194.79
##
## Step:  AIC=185.75
## RCP ~ RE + QT_CAT + ESTADO_ULTIMO_CONTROL + EDAD_DIAGNOSTICO
##
##                        Df Deviance    AIC
## + RETRASOS              1   160.85 184.85
## + Tn                    3   157.09 185.09
## <none>                      163.75 185.75
## + FECHA_DIAGNOSTICO     1   162.49 186.49
## + FECHA_INICIO_QT       1   162.65 186.65
## + ESTADO_MENOPAUSICO    1   162.94 186.94
## + HISTOLOGIA_CAT        1   163.00 187.00
## + Ki67_CAT              1   163.08 187.08
## + TAMAÑO                1   163.39 187.39
## + No_ANTIBIOTICOS_CAT   1   163.60 187.60
## + FENOTIPO_IHQ_CAT      2   161.61 187.61
## + RP                    1   163.62 187.62
## + FECHA_ULTIMO_CONTROL  1   163.65 187.65
## + GRADO_CAT             1   163.73 187.73
## + TIPO_CIRUGIA          1   163.74 187.74
## + ESTADIO_CAT           2   162.27 188.27
## + Nx                    3   161.19 189.19
## + HT_ADY_OK             6   158.07 192.07
##
## Step:  AIC=184.85
## RCP ~ RE + QT_CAT + ESTADO_ULTIMO_CONTROL + EDAD_DIAGNOSTICO +
##     RETRASOS
##
##                        Df Deviance    AIC
## <none>                      160.85 184.85
## + Tn                    3   155.49 185.49
## + FECHA_DIAGNOSTICO     1   159.92 185.92
## + FECHA_INICIO_QT       1   160.04 186.04
## + HISTOLOGIA_CAT        1   160.06 186.06
## + ESTADO_MENOPAUSICO    1   160.10 186.10
## + Ki67_CAT              1   160.33 186.33
## + RP                    1   160.56 186.56
## + TAMAÑO                1   160.60 186.60
## + FECHA_ULTIMO_CONTROL  1   160.79 186.79
## + No_ANTIBIOTICOS_CAT   1   160.79 186.79
## + GRADO_CAT             1   160.84 186.84
## + TIPO_CIRUGIA          1   160.85 186.85
## + FENOTIPO_IHQ_CAT      2   159.06 187.06
## + ESTADIO_CAT           2   159.91 187.91
## + Nx                    3   157.96 187.96
## + HT_ADY_OK             6   156.12 192.12
Código
<- stepAIC (mod_completo, direction = "backward" )
## Start:  AIC=208.04
## RCP ~ EDAD_DIAGNOSTICO + ESTADO_MENOPAUSICO + TAMAÑO + Tn +
##     Nx + TIPO_CIRUGIA + HT_ADY_OK + RE + RP + RETRASOS + FECHA_ULTIMO_CONTROL +
##     FECHA_INICIO_QT + FECHA_DIAGNOSTICO + ESTADO_ULTIMO_CONTROL +
##     GRADO_CAT + HISTOLOGIA_CAT + Ki67_CAT + FENOTIPO_IHQ_CAT +
##     ESTADIO_CAT + QT_CAT + No_ANTIBIOTICOS_CAT
##
##                         Df Deviance    AIC
## - HT_ADY_OK              6   136.93 202.93
## - ESTADIO_CAT            2   131.45 205.45
## - Tn                     3   134.03 206.03
## - Ki67_CAT               1   130.04 206.04
## - RETRASOS               1   130.05 206.05
## - FECHA_INICIO_QT        1   130.05 206.05
## - FECHA_ULTIMO_CONTROL   1   130.10 206.10
## - RP                     1   130.16 206.16
## - HISTOLOGIA_CAT         1   130.19 206.19
## - GRADO_CAT              1   130.34 206.34
## - FECHA_DIAGNOSTICO      1   130.53 206.53
## - TIPO_CIRUGIA           1   131.24 207.24
## - Nx                     3   135.85 207.85
## - ESTADO_MENOPAUSICO     1   131.93 207.93
## <none>                       130.04 208.04
## - RE                     1   132.66 208.66
## - FENOTIPO_IHQ_CAT       2   134.78 208.78
## - No_ANTIBIOTICOS_CAT    1   132.87 208.87
## - EDAD_DIAGNOSTICO       4   139.38 209.38
## - TAMAÑO                 1   135.09 211.09
## - QT_CAT                 2   139.10 213.10
## - ESTADO_ULTIMO_CONTROL  3   147.15 219.15
##
## Step:  AIC=202.92
## RCP ~ EDAD_DIAGNOSTICO + ESTADO_MENOPAUSICO + TAMAÑO + Tn +
##     Nx + TIPO_CIRUGIA + RE + RP + RETRASOS + FECHA_ULTIMO_CONTROL +
##     FECHA_INICIO_QT + FECHA_DIAGNOSTICO + ESTADO_ULTIMO_CONTROL +
##     GRADO_CAT + HISTOLOGIA_CAT + Ki67_CAT + FENOTIPO_IHQ_CAT +
##     ESTADIO_CAT + QT_CAT + No_ANTIBIOTICOS_CAT
##
##                         Df Deviance    AIC
## - ESTADIO_CAT            2   138.72 200.72
## - Tn                     3   140.77 200.77
## - FECHA_INICIO_QT        1   136.93 200.93
## - RP                     1   136.95 200.95
## - HISTOLOGIA_CAT         1   137.06 201.06
## - GRADO_CAT              1   137.12 201.12
## - FECHA_DIAGNOSTICO      1   137.13 201.13
## - RETRASOS               1   137.16 201.16
## - Ki67_CAT               1   137.21 201.21
## - TIPO_CIRUGIA           1   137.25 201.25
## - FECHA_ULTIMO_CONTROL   1   137.44 201.44
## - ESTADO_MENOPAUSICO     1   137.63 201.63
## <none>                       136.93 202.93
## - Nx                     3   143.11 203.11
## - No_ANTIBIOTICOS_CAT    1   139.19 203.19
## - FENOTIPO_IHQ_CAT       2   141.43 203.43
## - EDAD_DIAGNOSTICO       4   147.03 205.03
## - TAMAÑO                 1   141.60 205.60
## - QT_CAT                 2   144.18 206.18
## - RE                     1   144.87 208.87
## - ESTADO_ULTIMO_CONTROL  3   152.07 212.07
##
## Step:  AIC=200.72
## RCP ~ EDAD_DIAGNOSTICO + ESTADO_MENOPAUSICO + TAMAÑO + Tn +
##     Nx + TIPO_CIRUGIA + RE + RP + RETRASOS + FECHA_ULTIMO_CONTROL +
##     FECHA_INICIO_QT + FECHA_DIAGNOSTICO + ESTADO_ULTIMO_CONTROL +
##     GRADO_CAT + HISTOLOGIA_CAT + Ki67_CAT + FENOTIPO_IHQ_CAT +
##     QT_CAT + No_ANTIBIOTICOS_CAT
##
##                         Df Deviance    AIC
## - FECHA_INICIO_QT        1   138.72 198.72
## - GRADO_CAT              1   138.75 198.75
## - TIPO_CIRUGIA           1   138.86 198.86
## - HISTOLOGIA_CAT         1   138.88 198.88
## - FECHA_DIAGNOSTICO      1   138.95 198.95
## - RP                     1   138.96 198.96
## - FECHA_ULTIMO_CONTROL   1   138.98 198.98
## - RETRASOS               1   139.01 199.01
## - ESTADO_MENOPAUSICO     1   139.47 199.47
## - Ki67_CAT               1   139.49 199.49
## - Nx                     3   144.05 200.05
## <none>                       138.72 200.72
## - No_ANTIBIOTICOS_CAT    1   140.92 200.92
## - FENOTIPO_IHQ_CAT       2   143.15 201.15
## - TAMAÑO                 1   142.98 202.98
## - QT_CAT                 2   146.06 204.06
## - EDAD_DIAGNOSTICO       4   150.15 204.15
## - RE                     1   145.79 205.79
## - Tn                     3   150.21 206.21
## - ESTADO_ULTIMO_CONTROL  3   155.58 211.58
##
## Step:  AIC=198.72
## RCP ~ EDAD_DIAGNOSTICO + ESTADO_MENOPAUSICO + TAMAÑO + Tn +
##     Nx + TIPO_CIRUGIA + RE + RP + RETRASOS + FECHA_ULTIMO_CONTROL +
##     FECHA_DIAGNOSTICO + ESTADO_ULTIMO_CONTROL + GRADO_CAT + HISTOLOGIA_CAT +
##     Ki67_CAT + FENOTIPO_IHQ_CAT + QT_CAT + No_ANTIBIOTICOS_CAT
##
##                         Df Deviance    AIC
## - GRADO_CAT              1   138.75 196.75
## - TIPO_CIRUGIA           1   138.86 196.86
## - HISTOLOGIA_CAT         1   138.88 196.88
## - RP                     1   138.96 196.96
## - FECHA_ULTIMO_CONTROL   1   138.98 196.98
## - RETRASOS               1   139.01 197.01
## - ESTADO_MENOPAUSICO     1   139.47 197.47
## - Ki67_CAT               1   139.49 197.49
## - Nx                     3   144.06 198.06
## <none>                       138.72 198.72
## - No_ANTIBIOTICOS_CAT    1   140.92 198.92
## - FECHA_DIAGNOSTICO      1   141.06 199.06
## - FENOTIPO_IHQ_CAT       2   143.22 199.22
## - TAMAÑO                 1   143.04 201.04
## - EDAD_DIAGNOSTICO       4   150.15 202.15
## - QT_CAT                 2   146.38 202.38
## - RE                     1   145.80 203.80
## - Tn                     3   150.21 204.21
## - ESTADO_ULTIMO_CONTROL  3   155.58 209.58
##
## Step:  AIC=196.75
## RCP ~ EDAD_DIAGNOSTICO + ESTADO_MENOPAUSICO + TAMAÑO + Tn +
##     Nx + TIPO_CIRUGIA + RE + RP + RETRASOS + FECHA_ULTIMO_CONTROL +
##     FECHA_DIAGNOSTICO + ESTADO_ULTIMO_CONTROL + HISTOLOGIA_CAT +
##     Ki67_CAT + FENOTIPO_IHQ_CAT + QT_CAT + No_ANTIBIOTICOS_CAT
##
##                         Df Deviance    AIC
## - TIPO_CIRUGIA           1   138.89 194.89
## - HISTOLOGIA_CAT         1   138.92 194.92
## - FECHA_ULTIMO_CONTROL   1   139.00 195.00
## - RP                     1   139.00 195.00
## - RETRASOS               1   139.04 195.04
## - ESTADO_MENOPAUSICO     1   139.54 195.54
## - Ki67_CAT               1   139.54 195.54
## - Nx                     3   144.06 196.06
## <none>                       138.75 196.75
## - No_ANTIBIOTICOS_CAT    1   141.02 197.02
## - FECHA_DIAGNOSTICO      1   141.10 197.10
## - FENOTIPO_IHQ_CAT       2   143.24 197.24
## - TAMAÑO                 1   143.14 199.14
## - QT_CAT                 2   146.66 200.66
## - EDAD_DIAGNOSTICO       4   150.80 200.80
## - RE                     1   146.02 202.02
## - Tn                     3   150.34 202.34
## - ESTADO_ULTIMO_CONTROL  3   155.59 207.59
##
## Step:  AIC=194.89
## RCP ~ EDAD_DIAGNOSTICO + ESTADO_MENOPAUSICO + TAMAÑO + Tn +
##     Nx + RE + RP + RETRASOS + FECHA_ULTIMO_CONTROL + FECHA_DIAGNOSTICO +
##     ESTADO_ULTIMO_CONTROL + HISTOLOGIA_CAT + Ki67_CAT + FENOTIPO_IHQ_CAT +
##     QT_CAT + No_ANTIBIOTICOS_CAT
##
##                         Df Deviance    AIC
## - HISTOLOGIA_CAT         1   138.99 192.99
## - FECHA_ULTIMO_CONTROL   1   139.10 193.10
## - RETRASOS               1   139.15 193.15
## - RP                     1   139.19 193.19
## - ESTADO_MENOPAUSICO     1   139.62 193.62
## - Ki67_CAT               1   139.78 193.78
## - Nx                     3   144.12 194.12
## <none>                       138.89 194.89
## - No_ANTIBIOTICOS_CAT    1   141.17 195.17
## - FENOTIPO_IHQ_CAT       2   143.25 195.25
## - FECHA_DIAGNOSTICO      1   141.30 195.30
## - TAMAÑO                 1   143.18 197.18
## - EDAD_DIAGNOSTICO       4   150.84 198.84
## - QT_CAT                 2   147.00 199.00
## - RE                     1   146.04 200.04
## - Tn                     3   150.74 200.74
## - ESTADO_ULTIMO_CONTROL  3   156.20 206.20
##
## Step:  AIC=192.99
## RCP ~ EDAD_DIAGNOSTICO + ESTADO_MENOPAUSICO + TAMAÑO + Tn +
##     Nx + RE + RP + RETRASOS + FECHA_ULTIMO_CONTROL + FECHA_DIAGNOSTICO +
##     ESTADO_ULTIMO_CONTROL + Ki67_CAT + FENOTIPO_IHQ_CAT + QT_CAT +
##     No_ANTIBIOTICOS_CAT
##
##                         Df Deviance    AIC
## - FECHA_ULTIMO_CONTROL   1   139.17 191.17
## - RETRASOS               1   139.27 191.27
## - RP                     1   139.41 191.41
## - ESTADO_MENOPAUSICO     1   139.69 191.69
## - Ki67_CAT               1   140.13 192.13
## <none>                       138.99 192.99
## - Nx                     3   145.08 193.08
## - FENOTIPO_IHQ_CAT       2   143.29 193.29
## - No_ANTIBIOTICOS_CAT    1   141.37 193.37
## - FECHA_DIAGNOSTICO      1   141.39 193.39
## - TAMAÑO                 1   143.26 195.26
## - EDAD_DIAGNOSTICO       4   150.85 196.85
## - QT_CAT                 2   147.63 197.63
## - RE                     1   146.05 198.05
## - Tn                     3   150.91 198.91
## - ESTADO_ULTIMO_CONTROL  3   156.28 204.28
##
## Step:  AIC=191.17
## RCP ~ EDAD_DIAGNOSTICO + ESTADO_MENOPAUSICO + TAMAÑO + Tn +
##     Nx + RE + RP + RETRASOS + FECHA_DIAGNOSTICO + ESTADO_ULTIMO_CONTROL +
##     Ki67_CAT + FENOTIPO_IHQ_CAT + QT_CAT + No_ANTIBIOTICOS_CAT
##
##                         Df Deviance    AIC
## - RETRASOS               1   139.45 189.45
## - RP                     1   139.68 189.68
## - ESTADO_MENOPAUSICO     1   139.83 189.83
## - Ki67_CAT               1   140.36 190.36
## <none>                       139.17 191.17
## - Nx                     3   145.21 191.21
## - FENOTIPO_IHQ_CAT       2   143.31 191.31
## - FECHA_DIAGNOSTICO      1   141.42 191.42
## - No_ANTIBIOTICOS_CAT    1   141.53 191.53
## - TAMAÑO                 1   143.26 193.26
## - EDAD_DIAGNOSTICO       4   151.00 195.00
## - QT_CAT                 2   147.86 195.86
## - RE                     1   146.05 196.05
## - Tn                     3   150.92 196.92
## - ESTADO_ULTIMO_CONTROL  3   157.54 203.54
##
## Step:  AIC=189.45
## RCP ~ EDAD_DIAGNOSTICO + ESTADO_MENOPAUSICO + TAMAÑO + Tn +
##     Nx + RE + RP + FECHA_DIAGNOSTICO + ESTADO_ULTIMO_CONTROL +
##     Ki67_CAT + FENOTIPO_IHQ_CAT + QT_CAT + No_ANTIBIOTICOS_CAT
##
##                         Df Deviance    AIC
## - RP                     1   139.91 187.91
## - ESTADO_MENOPAUSICO     1   140.09 188.09
## - Ki67_CAT               1   140.80 188.80
## <none>                       139.45 189.45
## - Nx                     3   145.67 189.67
## - FECHA_DIAGNOSTICO      1   141.85 189.85
## - FENOTIPO_IHQ_CAT       2   143.90 189.90
## - No_ANTIBIOTICOS_CAT    1   142.02 190.02
## - TAMAÑO                 1   143.96 191.96
## - EDAD_DIAGNOSTICO       4   151.21 193.21
## - QT_CAT                 2   148.18 194.18
## - RE                     1   146.69 194.69
## - Tn                     3   152.66 196.66
## - ESTADO_ULTIMO_CONTROL  3   157.94 201.94
##
## Step:  AIC=187.92
## RCP ~ EDAD_DIAGNOSTICO + ESTADO_MENOPAUSICO + TAMAÑO + Tn +
##     Nx + RE + FECHA_DIAGNOSTICO + ESTADO_ULTIMO_CONTROL + Ki67_CAT +
##     FENOTIPO_IHQ_CAT + QT_CAT + No_ANTIBIOTICOS_CAT
##
##                         Df Deviance    AIC
## - ESTADO_MENOPAUSICO     1   140.56 186.56
## - Ki67_CAT               1   141.22 187.22
## <none>                       139.91 187.91
## - Nx                     3   146.07 188.07
## - FENOTIPO_IHQ_CAT       2   144.22 188.22
## - FECHA_DIAGNOSTICO      1   142.33 188.33
## - No_ANTIBIOTICOS_CAT    1   142.36 188.36
## - TAMAÑO                 1   144.60 190.60
## - EDAD_DIAGNOSTICO       4   151.35 191.35
## - QT_CAT                 2   148.39 192.39
## - Tn                     3   152.86 194.86
## - RE                     1   153.36 199.36
## - ESTADO_ULTIMO_CONTROL  3   158.16 200.16
##
## Step:  AIC=186.55
## RCP ~ EDAD_DIAGNOSTICO + TAMAÑO + Tn + Nx + RE + FECHA_DIAGNOSTICO +
##     ESTADO_ULTIMO_CONTROL + Ki67_CAT + FENOTIPO_IHQ_CAT + QT_CAT +
##     No_ANTIBIOTICOS_CAT
##
##                         Df Deviance    AIC
## - Ki67_CAT               1   141.94 185.94
## <none>                       140.56 186.56
## - FENOTIPO_IHQ_CAT       2   144.59 186.59
## - FECHA_DIAGNOSTICO      1   142.80 186.80
## - No_ANTIBIOTICOS_CAT    1   142.95 186.95
## - Nx                     3   147.04 187.04
## - TAMAÑO                 1   144.99 188.99
## - EDAD_DIAGNOSTICO       4   151.57 189.57
## - QT_CAT                 2   148.88 190.88
## - Tn                     3   153.62 193.62
## - RE                     1   153.47 197.47
## - ESTADO_ULTIMO_CONTROL  3   158.46 198.46
##
## Step:  AIC=185.94
## RCP ~ EDAD_DIAGNOSTICO + TAMAÑO + Tn + Nx + RE + FECHA_DIAGNOSTICO +
##     ESTADO_ULTIMO_CONTROL + FENOTIPO_IHQ_CAT + QT_CAT + No_ANTIBIOTICOS_CAT
##
##                         Df Deviance    AIC
## - FECHA_DIAGNOSTICO      1   143.54 185.54
## - FENOTIPO_IHQ_CAT       2   145.77 185.77
## <none>                       141.94 185.94
## - Nx                     3   148.23 186.23
## - No_ANTIBIOTICOS_CAT    1   144.54 186.54
## - TAMAÑO                 1   146.44 188.44
## - EDAD_DIAGNOSTICO       4   152.64 188.64
## - QT_CAT                 2   151.02 191.02
## - Tn                     3   154.98 192.98
## - ESTADO_ULTIMO_CONTROL  3   159.04 197.04
## - RE                     1   157.33 199.33
##
## Step:  AIC=185.54
## RCP ~ EDAD_DIAGNOSTICO + TAMAÑO + Tn + Nx + RE + ESTADO_ULTIMO_CONTROL +
##     FENOTIPO_IHQ_CAT + QT_CAT + No_ANTIBIOTICOS_CAT
##
##                         Df Deviance    AIC
## - Nx                     3   149.09 185.09
## - FENOTIPO_IHQ_CAT       2   147.40 185.40
## <none>                       143.54 185.54
## - No_ANTIBIOTICOS_CAT    1   145.98 185.98
## - EDAD_DIAGNOSTICO       4   153.26 187.26
## - TAMAÑO                 1   147.42 187.42
## - QT_CAT                 2   151.59 189.59
## - Tn                     3   157.15 193.15
## - ESTADO_ULTIMO_CONTROL  3   160.04 196.04
## - RE                     1   160.66 200.66
##
## Step:  AIC=185.09
## RCP ~ EDAD_DIAGNOSTICO + TAMAÑO + Tn + RE + ESTADO_ULTIMO_CONTROL +
##     FENOTIPO_IHQ_CAT + QT_CAT + No_ANTIBIOTICOS_CAT
##
##                         Df Deviance    AIC
## - FENOTIPO_IHQ_CAT       2   152.25 184.25
## - No_ANTIBIOTICOS_CAT    1   151.08 185.08
## <none>                       149.09 185.09
## - EDAD_DIAGNOSTICO       4   160.07 188.07
## - TAMAÑO                 1   154.17 188.17
## - QT_CAT                 2   156.60 188.60
## - Tn                     3   160.81 190.81
## - ESTADO_ULTIMO_CONTROL  3   168.12 198.12
## - RE                     1   170.62 204.62
##
## Step:  AIC=184.25
## RCP ~ EDAD_DIAGNOSTICO + TAMAÑO + Tn + RE + ESTADO_ULTIMO_CONTROL +
##     QT_CAT + No_ANTIBIOTICOS_CAT
##
##                         Df Deviance    AIC
## - No_ANTIBIOTICOS_CAT    1   153.21 183.21
## <none>                       152.25 184.25
## - TAMAÑO                 1   156.37 186.37
## - EDAD_DIAGNOSTICO       4   163.69 187.69
## - Tn                     3   163.18 189.18
## - ESTADO_ULTIMO_CONTROL  3   171.37 197.37
## - QT_CAT                 2   174.07 202.07
## - RE                     1   181.75 211.75
##
## Step:  AIC=183.21
## RCP ~ EDAD_DIAGNOSTICO + TAMAÑO + Tn + RE + ESTADO_ULTIMO_CONTROL +
##     QT_CAT
##
##                         Df Deviance    AIC
## <none>                       153.21 183.21
## - TAMAÑO                 1   157.09 185.09
## - Tn                     3   163.39 187.39
## - EDAD_DIAGNOSTICO       4   166.26 188.26
## - ESTADO_ULTIMO_CONTROL  3   173.16 197.16
## - QT_CAT                 2   174.91 200.91
## - RE                     1   182.92 210.92
Código
<- stepAIC (mod_basico, direction = "both" ,scope = list (lower = formula (mod_basico),upper = formula (mod_completo)))
## Start:  AIC=231.97
## RCP ~ 1
##
##                         Df Deviance    AIC
## + RE                     1   210.88 214.88
## + FENOTIPO_IHQ_CAT       2   210.96 216.96
## + QT_CAT                 2   214.59 220.59
## + ESTADO_ULTIMO_CONTROL  3   216.80 224.80
## + Ki67_CAT               1   223.80 227.80
## + HT_ADY_OK              6   214.07 228.07
## + RP                     1   224.10 228.10
## + EDAD_DIAGNOSTICO       4   218.97 228.97
## + RETRASOS               1   225.27 229.27
## + GRADO_CAT              1   225.57 229.57
## + Nx                     3   222.45 230.45
## <none>                       229.97 231.97
## + No_ANTIBIOTICOS_CAT    1   228.11 232.11
## + FECHA_ULTIMO_CONTROL   1   228.75 232.75
## + FECHA_DIAGNOSTICO      1   228.91 232.91
## + TIPO_CIRUGIA           1   229.17 233.17
## + FECHA_INICIO_QT        1   229.24 233.24
## + ESTADIO_CAT            2   227.30 233.30
## + TAMAÑO                 1   229.73 233.73
## + HISTOLOGIA_CAT         1   229.83 233.83
## + ESTADO_MENOPAUSICO     1   229.96 233.96
## + Tn                     3   227.19 235.19
##
## Step:  AIC=214.88
## RCP ~ RE
##
##                         Df Deviance    AIC
## + QT_CAT                 2   190.40 198.40
## + FENOTIPO_IHQ_CAT       2   192.93 200.93
## + ESTADO_ULTIMO_CONTROL  3   194.14 204.14
## + RETRASOS               1   207.51 213.51
## + EDAD_DIAGNOSTICO       4   201.72 213.72
## <none>                       210.88 214.88
## + Ki67_CAT               1   209.38 215.38
## + ESTADIO_CAT            2   207.41 215.41
## + No_ANTIBIOTICOS_CAT    1   209.65 215.65
## + GRADO_CAT              1   210.11 216.11
## + FECHA_ULTIMO_CONTROL   1   210.18 216.18
## + Tn                     3   206.19 216.19
## + TAMAÑO                 1   210.42 216.42
## + FECHA_INICIO_QT        1   210.49 216.49
## + FECHA_DIAGNOSTICO      1   210.49 216.49
## + TIPO_CIRUGIA           1   210.54 216.54
## + HISTOLOGIA_CAT         1   210.78 216.78
## + RP                     1   210.83 216.83
## + ESTADO_MENOPAUSICO     1   210.88 216.88
## + Nx                     3   208.77 218.77
## + HT_ADY_OK              6   206.91 222.91
## - RE                     1   229.97 231.97
##
## Step:  AIC=198.4
## RCP ~ RE + QT_CAT
##
##                         Df Deviance    AIC
## + ESTADO_ULTIMO_CONTROL  3   175.36 189.36
## + EDAD_DIAGNOSTICO       4   179.32 195.32
## + RETRASOS               1   187.12 197.12
## + ESTADIO_CAT            2   186.18 198.18
## <none>                       190.40 198.40
## + No_ANTIBIOTICOS_CAT    1   189.11 199.11
## + FECHA_ULTIMO_CONTROL   1   189.18 199.18
## + Tn                     3   185.45 199.45
## + TAMAÑO                 1   189.87 199.87
## + TIPO_CIRUGIA           1   189.93 199.93
## + Nx                     3   186.00 200.00
## + FECHA_DIAGNOSTICO      1   190.05 200.05
## + FECHA_INICIO_QT        1   190.06 200.06
## + FENOTIPO_IHQ_CAT       2   188.14 200.14
## + GRADO_CAT              1   190.22 200.22
## + Ki67_CAT               1   190.31 200.31
## + RP                     1   190.39 200.39
## + HISTOLOGIA_CAT         1   190.39 200.39
## + ESTADO_MENOPAUSICO     1   190.40 200.40
## + HT_ADY_OK              6   185.78 205.78
## - QT_CAT                 2   210.88 214.88
## - RE                     1   214.59 220.59
##
## Step:  AIC=189.36
## RCP ~ RE + QT_CAT + ESTADO_ULTIMO_CONTROL
##
##                         Df Deviance    AIC
## + EDAD_DIAGNOSTICO       4   163.75 185.75
## + Tn                     3   167.66 187.66
## + RETRASOS               1   172.44 188.44
## <none>                       175.36 189.36
## + ESTADIO_CAT            2   171.95 189.95
## + TAMAÑO                 1   174.20 190.20
## + No_ANTIBIOTICOS_CAT    1   174.45 190.45
## + FECHA_DIAGNOSTICO      1   174.75 190.75
## + FECHA_INICIO_QT        1   174.88 190.88
## + GRADO_CAT              1   175.04 191.04
## + FENOTIPO_IHQ_CAT       2   173.12 191.12
## + Ki67_CAT               1   175.16 191.16
## + ESTADO_MENOPAUSICO     1   175.22 191.22
## + HISTOLOGIA_CAT         1   175.26 191.26
## + RP                     1   175.32 191.32
## + FECHA_ULTIMO_CONTROL   1   175.34 191.34
## + TIPO_CIRUGIA           1   175.35 191.35
## + Nx                     3   172.88 192.88
## + HT_ADY_OK              6   168.79 194.79
## - ESTADO_ULTIMO_CONTROL  3   190.40 198.40
## - QT_CAT                 2   194.14 204.14
## - RE                     1   203.13 215.13
##
## Step:  AIC=185.75
## RCP ~ RE + QT_CAT + ESTADO_ULTIMO_CONTROL + EDAD_DIAGNOSTICO
##
##                         Df Deviance    AIC
## + RETRASOS               1   160.85 184.85
## + Tn                     3   157.09 185.09
## <none>                       163.75 185.75
## + FECHA_DIAGNOSTICO      1   162.49 186.49
## + FECHA_INICIO_QT        1   162.65 186.65
## + ESTADO_MENOPAUSICO     1   162.94 186.94
## + HISTOLOGIA_CAT         1   163.00 187.00
## + Ki67_CAT               1   163.08 187.08
## + TAMAÑO                 1   163.39 187.39
## + No_ANTIBIOTICOS_CAT    1   163.60 187.60
## + FENOTIPO_IHQ_CAT       2   161.61 187.61
## + RP                     1   163.62 187.62
## + FECHA_ULTIMO_CONTROL   1   163.65 187.65
## + GRADO_CAT              1   163.73 187.73
## + TIPO_CIRUGIA           1   163.74 187.74
## + ESTADIO_CAT            2   162.27 188.27
## + Nx                     3   161.19 189.19
## - EDAD_DIAGNOSTICO       4   175.36 189.36
## + HT_ADY_OK              6   158.07 192.07
## - ESTADO_ULTIMO_CONTROL  3   179.32 195.32
## - QT_CAT                 2   184.89 202.89
## - RE                     1   188.90 208.90
##
## Step:  AIC=184.85
## RCP ~ RE + QT_CAT + ESTADO_ULTIMO_CONTROL + EDAD_DIAGNOSTICO +
##     RETRASOS
##
##                         Df Deviance    AIC
## <none>                       160.85 184.85
## + Tn                     3   155.49 185.49
## - RETRASOS               1   163.75 185.75
## + FECHA_DIAGNOSTICO      1   159.92 185.92
## + FECHA_INICIO_QT        1   160.04 186.04
## + HISTOLOGIA_CAT         1   160.06 186.06
## + ESTADO_MENOPAUSICO     1   160.10 186.10
## + Ki67_CAT               1   160.33 186.33
## + RP                     1   160.56 186.56
## + TAMAÑO                 1   160.60 186.60
## + FECHA_ULTIMO_CONTROL   1   160.79 186.79
## + No_ANTIBIOTICOS_CAT    1   160.79 186.79
## + GRADO_CAT              1   160.84 186.84
## + TIPO_CIRUGIA           1   160.85 186.85
## + FENOTIPO_IHQ_CAT       2   159.06 187.06
## + ESTADIO_CAT            2   159.91 187.91
## + Nx                     3   157.96 187.96
## - EDAD_DIAGNOSTICO       4   172.44 188.44
## + HT_ADY_OK              6   156.12 192.12
## - ESTADO_ULTIMO_CONTROL  3   176.45 194.45
## - QT_CAT                 2   181.78 201.78
## - RE                     1   184.26 206.26
Resumen de ajustes
##
## Call:
## glm(formula = RCP ~ RE + QT_CAT + ESTADO_ULTIMO_CONTROL + EDAD_DIAGNOSTICO +
##     RETRASOS, family = binomial("logit"), data = dataset_modelo)
##
## Coefficients:
##                           Estimate Std. Error z value Pr(>|z|)
## (Intercept)                -1.6237     0.9408  -1.726 0.084378 .
## RE                         -0.9452     0.2116  -4.468 7.91e-06 ***
## QT_CATINMUNO              -18.4704  1236.2990  -0.015 0.988080
## QT_CATNO antiHER2          -1.4994     0.4205  -3.565 0.000363 ***
## ESTADO_ULTIMO_CONTROLMSE    0.6431     1.4628   0.440 0.660203
## ESTADO_ULTIMO_CONTROLVCE    0.4677     0.8732   0.536 0.592192
## ESTADO_ULTIMO_CONTROLVSE    2.1115     0.7515   2.810 0.004957 **
## EDAD_DIAGNOSTICO40-49       0.4800     0.5809   0.826 0.408650
## EDAD_DIAGNOSTICO50-59      -1.2035     0.6567  -1.833 0.066856 .
## EDAD_DIAGNOSTICO60-69       0.6866     0.6388   1.075 0.282470
## EDAD_DIAGNOSTICO70-79       0.4774     0.7641   0.625 0.532114
## RETRASOSSI                  0.6843     0.4042   1.693 0.090500 .
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## (Dispersion parameter for binomial family taken to be 1)
##
##     Null deviance: 229.97  on 173  degrees of freedom
## Residual deviance: 160.85  on 162  degrees of freedom
## AIC: 184.85
##
## Number of Fisher Scoring iterations: 15
##
## Call:
## glm(formula = RCP ~ EDAD_DIAGNOSTICO + TAMAÑO + Tn + RE + ESTADO_ULTIMO_CONTROL +
##     QT_CAT, family = binomial("logit"), data = dataset_modelo)
##
## Coefficients:
##                           Estimate Std. Error z value Pr(>|z|)
## (Intercept)                -3.5569     1.3693  -2.598  0.00938 **
## EDAD_DIAGNOSTICO40-49       0.5693     0.5952   0.956  0.33882
## EDAD_DIAGNOSTICO50-59      -1.3289     0.6850  -1.940  0.05237 .
## EDAD_DIAGNOSTICO60-69       0.7564     0.6647   1.138  0.25513
## EDAD_DIAGNOSTICO70-79       0.7429     0.7967   0.932  0.35113
## TAMAÑO                     -0.7104     0.3724  -1.908  0.05642 .
## Tn2                         1.2810     0.7730   1.657  0.09749 .
## Tn3                         3.4317     1.3572   2.529  0.01145 *
## Tn4                         3.1132     1.1867   2.623  0.00871 **
## RE                         -1.1168     0.2287  -4.884 1.04e-06 ***
## ESTADO_ULTIMO_CONTROLMSE    0.6491     1.6262   0.399  0.68976
## ESTADO_ULTIMO_CONTROLVCE    1.1775     1.0281   1.145  0.25208
## ESTADO_ULTIMO_CONTROLVSE    2.8611     0.9170   3.120  0.00181 **
## QT_CATINMUNO              -18.6034  1290.9444  -0.014  0.98850
## QT_CATNO antiHER2          -1.6092     0.4406  -3.652  0.00026 ***
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## (Dispersion parameter for binomial family taken to be 1)
##
##     Null deviance: 229.97  on 173  degrees of freedom
## Residual deviance: 153.21  on 159  degrees of freedom
## AIC: 183.21
##
## Number of Fisher Scoring iterations: 15
##
## Call:
## glm(formula = RCP ~ RE + QT_CAT + ESTADO_ULTIMO_CONTROL + EDAD_DIAGNOSTICO +
##     RETRASOS, family = binomial("logit"), data = dataset_modelo)
##
## Coefficients:
##                           Estimate Std. Error z value Pr(>|z|)
## (Intercept)                -1.6237     0.9408  -1.726 0.084378 .
## RE                         -0.9452     0.2116  -4.468 7.91e-06 ***
## QT_CATINMUNO              -18.4704  1236.2990  -0.015 0.988080
## QT_CATNO antiHER2          -1.4994     0.4205  -3.565 0.000363 ***
## ESTADO_ULTIMO_CONTROLMSE    0.6431     1.4628   0.440 0.660203
## ESTADO_ULTIMO_CONTROLVCE    0.4677     0.8732   0.536 0.592192
## ESTADO_ULTIMO_CONTROLVSE    2.1115     0.7515   2.810 0.004957 **
## EDAD_DIAGNOSTICO40-49       0.4800     0.5809   0.826 0.408650
## EDAD_DIAGNOSTICO50-59      -1.2035     0.6567  -1.833 0.066856 .
## EDAD_DIAGNOSTICO60-69       0.6866     0.6388   1.075 0.282470
## EDAD_DIAGNOSTICO70-79       0.4774     0.7641   0.625 0.532114
## RETRASOSSI                  0.6843     0.4042   1.693 0.090500 .
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## (Dispersion parameter for binomial family taken to be 1)
##
##     Null deviance: 229.97  on 173  degrees of freedom
## Residual deviance: 160.85  on 162  degrees of freedom
## AIC: 184.85
##
## Number of Fisher Scoring iterations: 15
Evaluación de modelos
Código
evaluar_modelo (modelo_basico, datos_validacion = dataset_modelo, variable_respuesta = "RCP" )## Setting levels: control = NO, case = SI ## Setting direction: controls < cases
Código
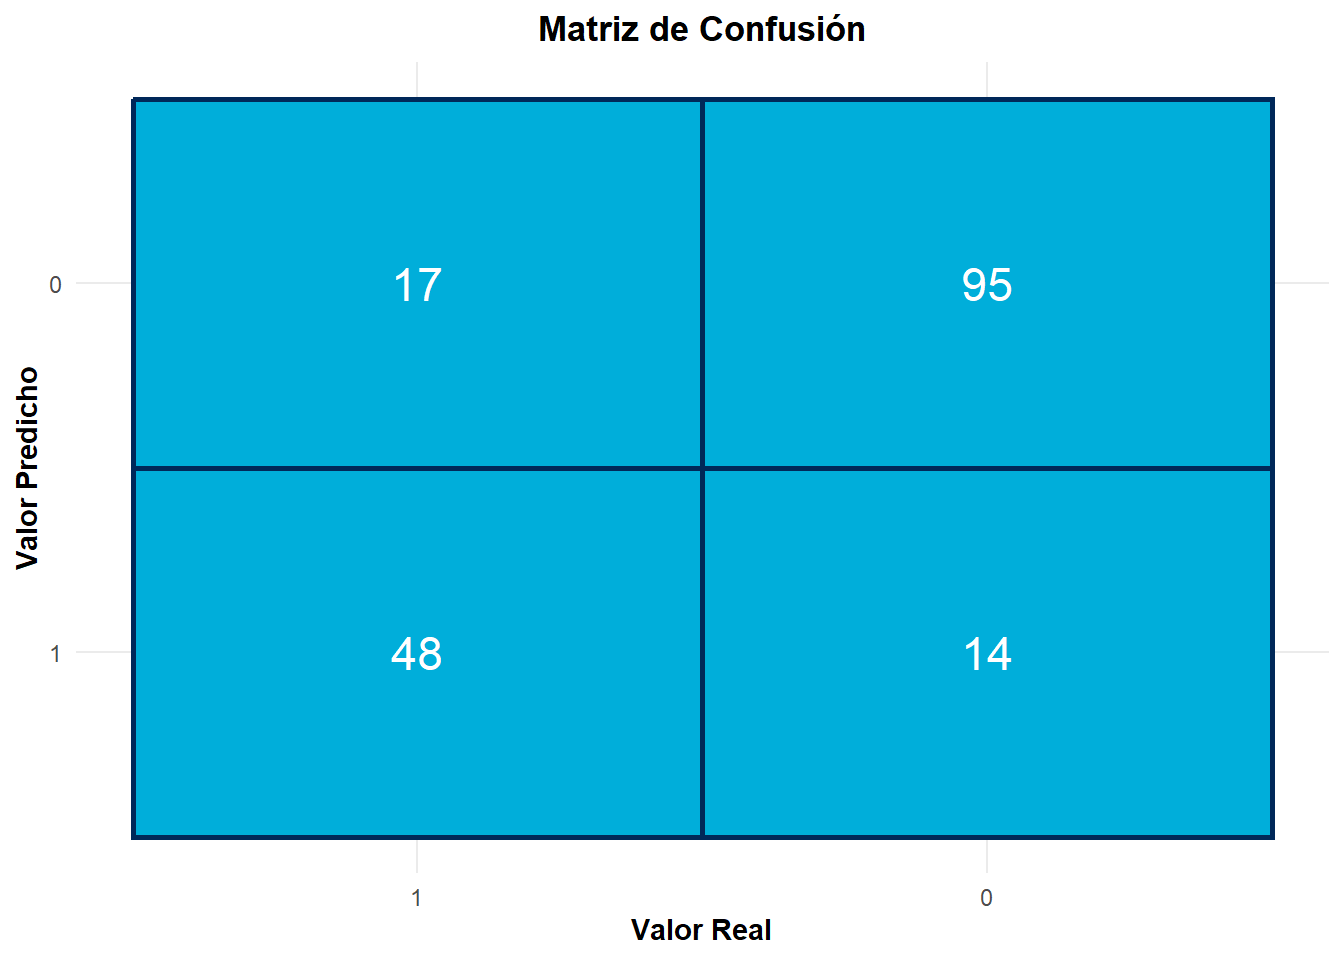
confusion_matrix_plot (modelo_basico, dataset_modelo, "RCP" )
Código
evaluar_modelo (mod_forward, datos_validacion = dataset_modelo, variable_respuesta = "RCP" )
Código
confusion_matrix_plot (mod_forward, dataset_modelo, "RCP" )
Código
evaluar_modelo (mod_backward, datos_validacion = dataset_modelo, variable_respuesta = "RCP" )## Setting levels: control = NO, case = SI ## Setting direction: controls < cases
Código
confusion_matrix_plot (mod_backward, dataset_modelo, "RCP" )
Código
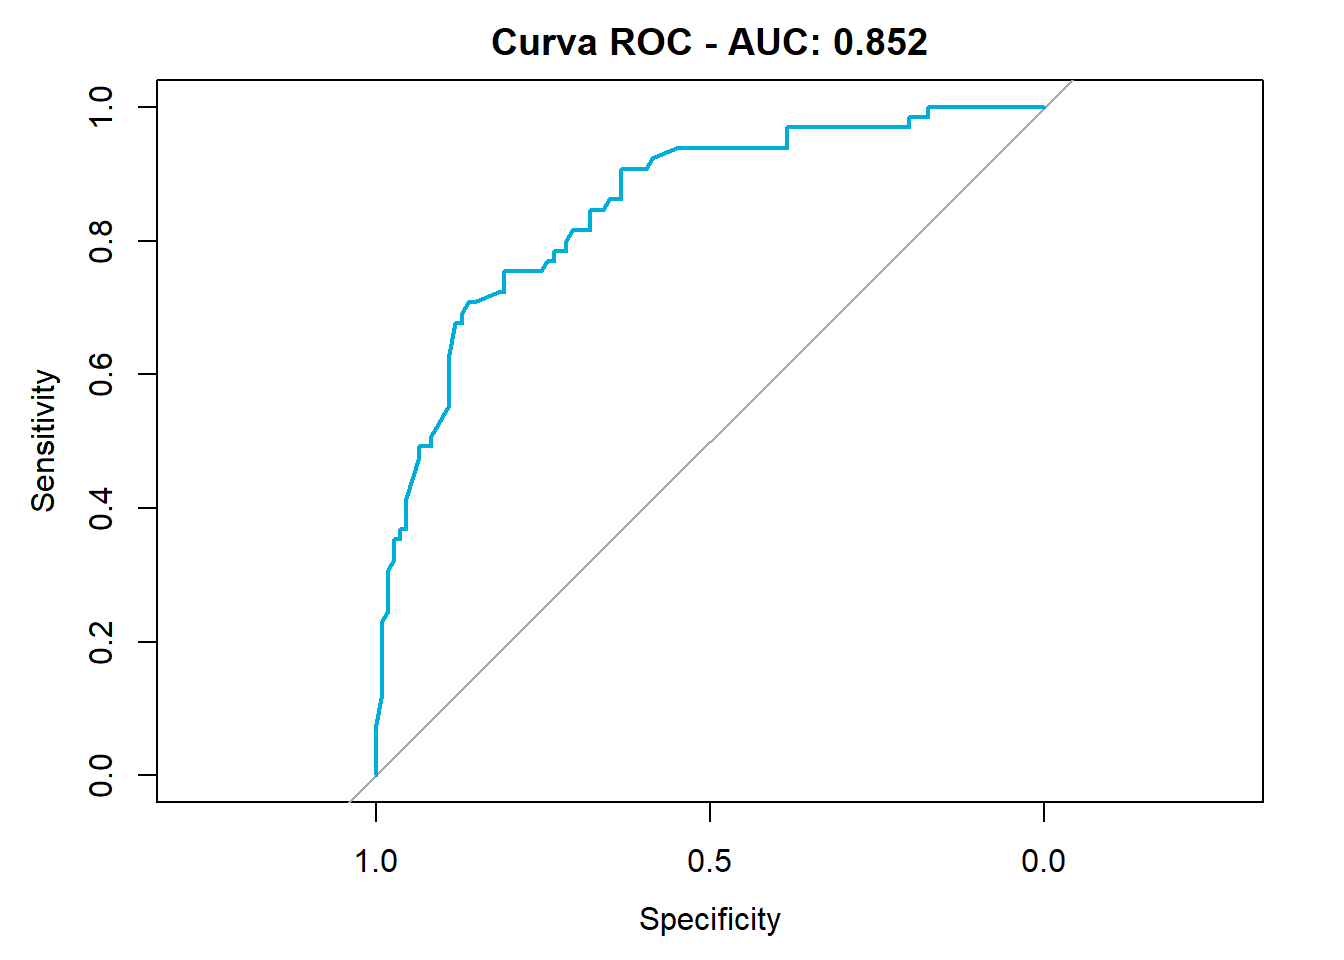
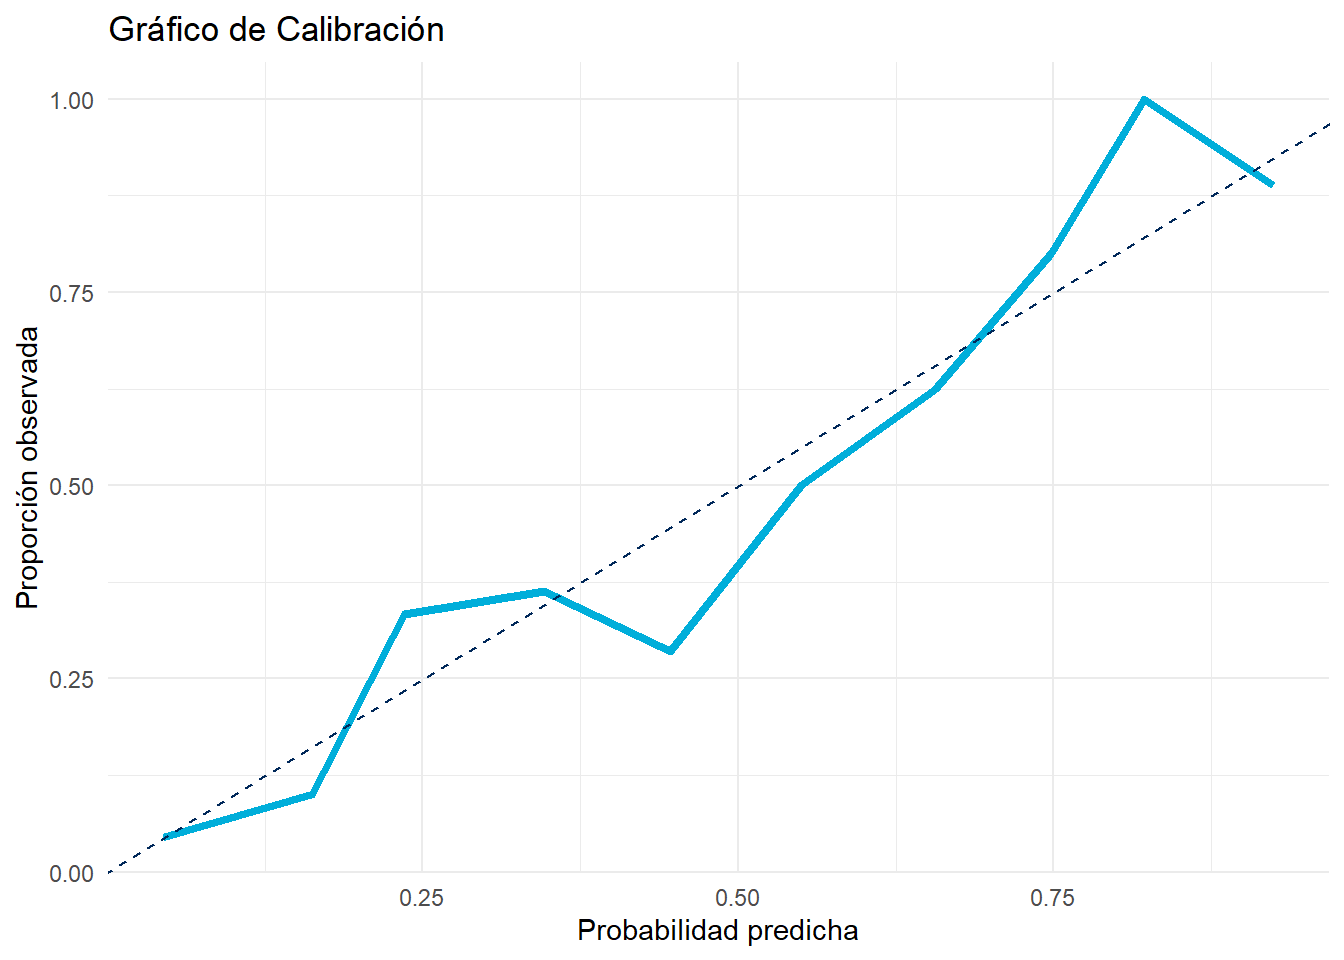
evaluar_modelo (mod_stepwise, datos_validacion = dataset_modelo, variable_respuesta = "RCP" )
Código
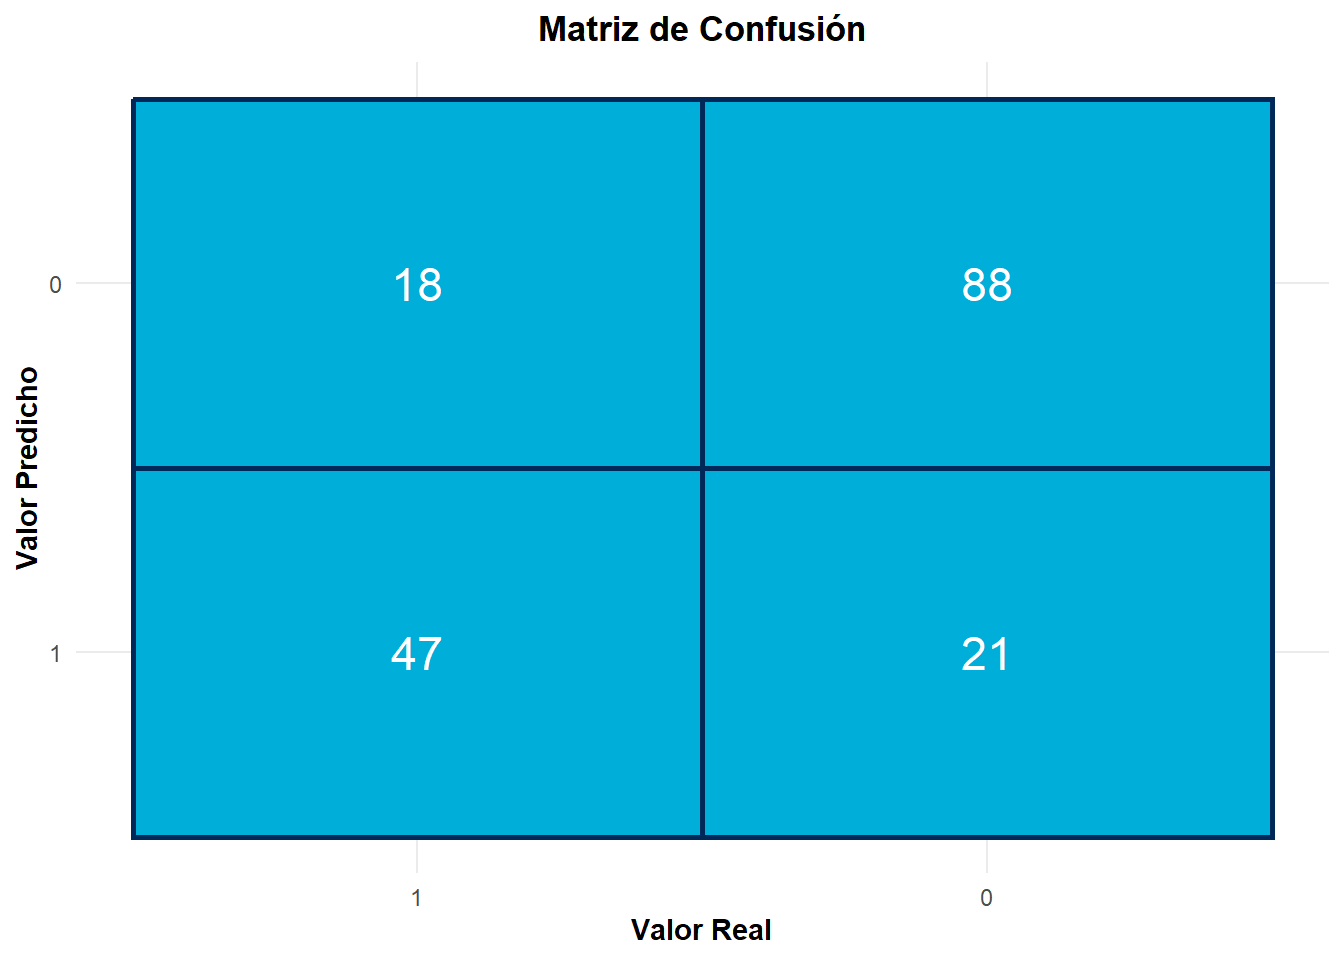
confusion_matrix_plot (mod_stepwise, dataset_modelo, "RCP" )
Concluyendo en este proceso, vamos a tener en cuenta 3 modelos diferentes.
RCP ~ . (Modelo básico)
RCP ~ RE + QT_CAT + ESTADO_ULTIMO_CONTROL + EDAD_DIAGNOSTICO + RETRASOS (Forward Selection / Stepwise Regression)
RCP ~ EDAD_DIAGNOSTICO + TAMAÑO + Tn + RE + ESTADO_ULTIMO_CONTROL + QT_CAT (Backward Elimination)
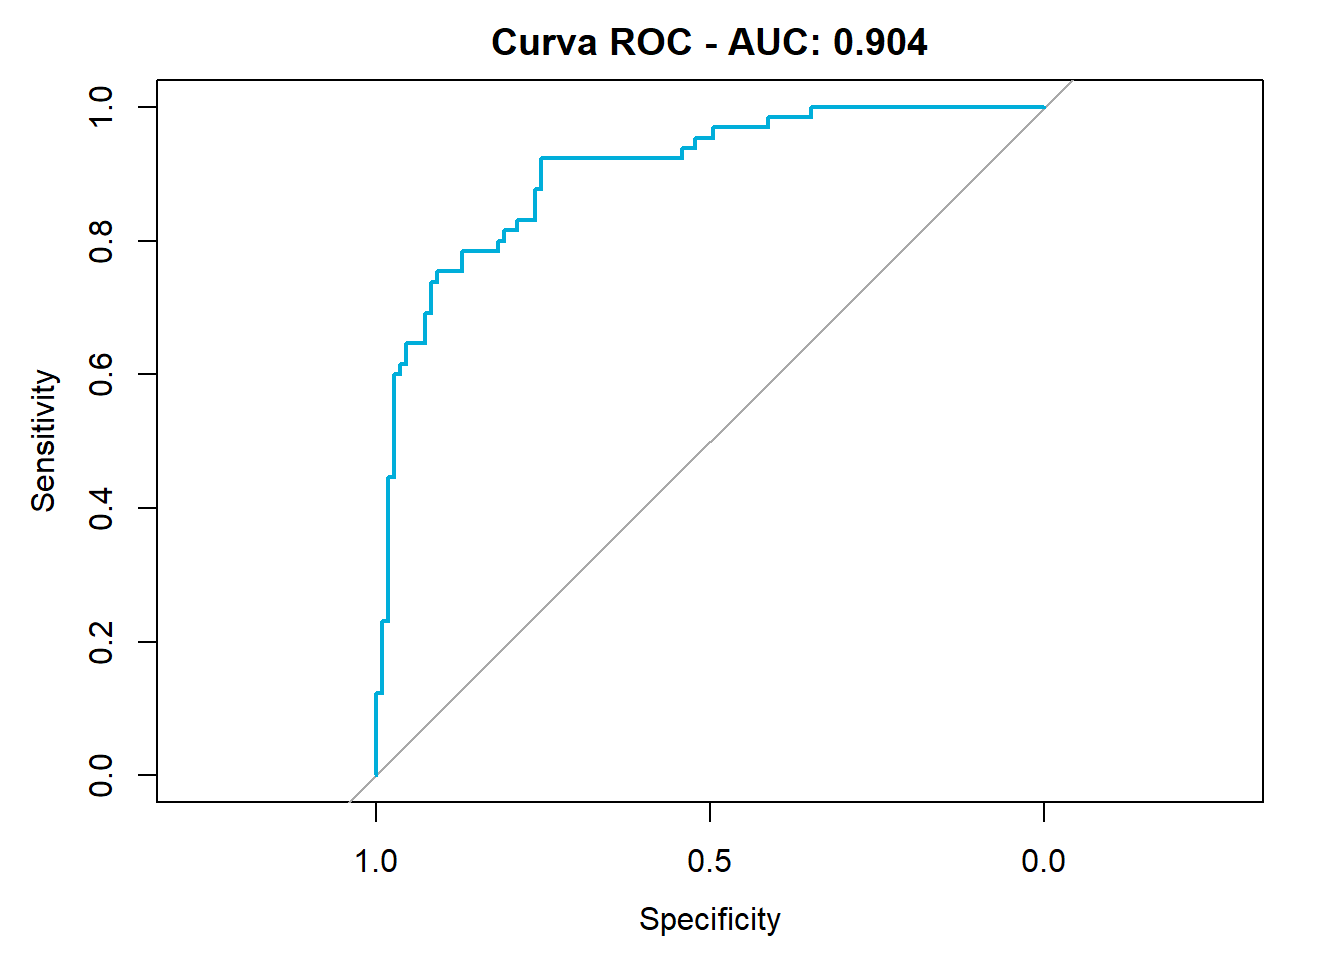
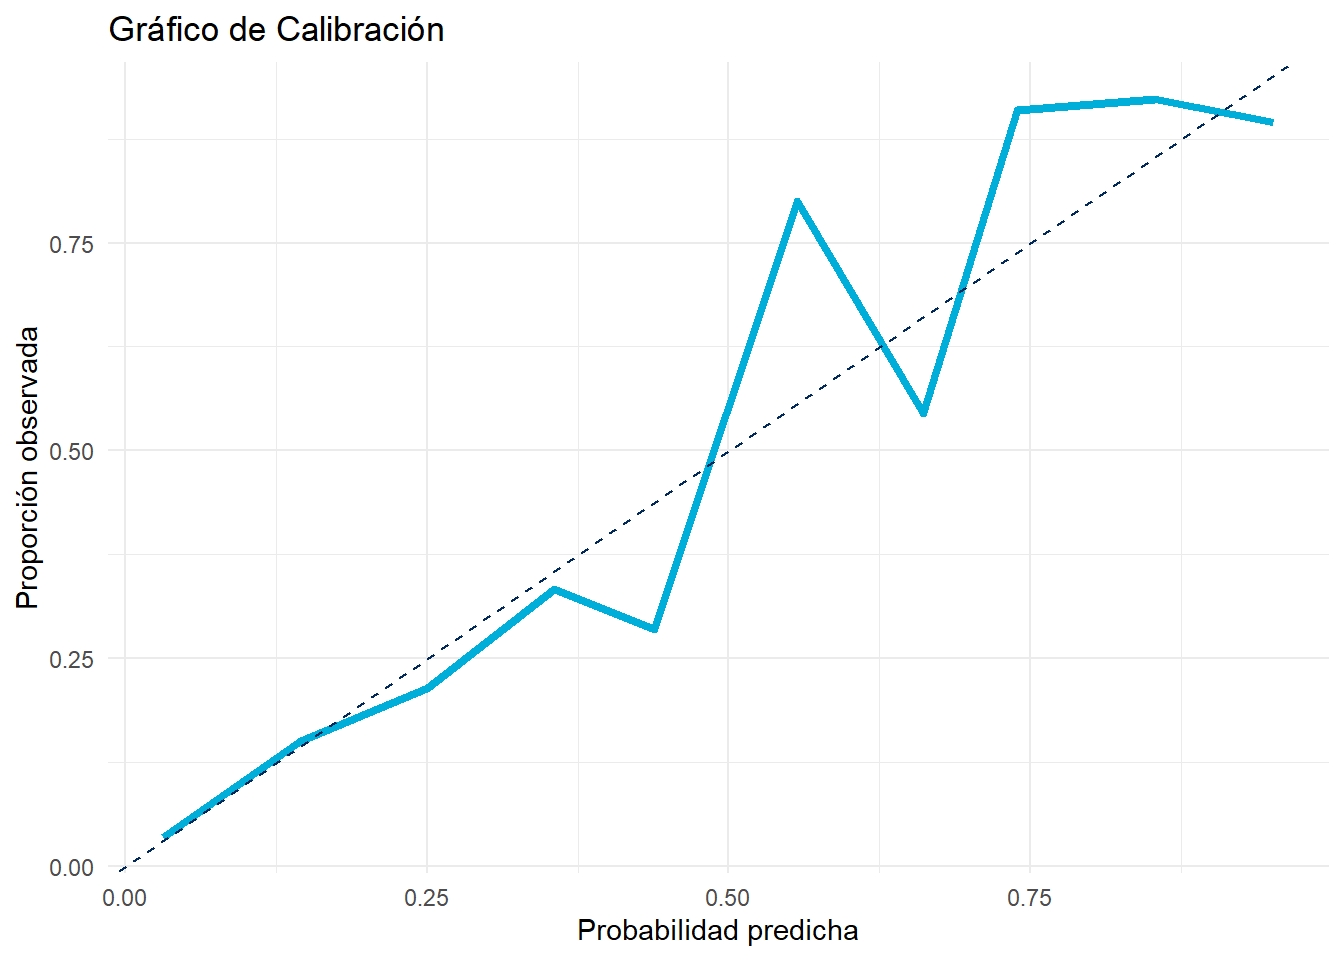
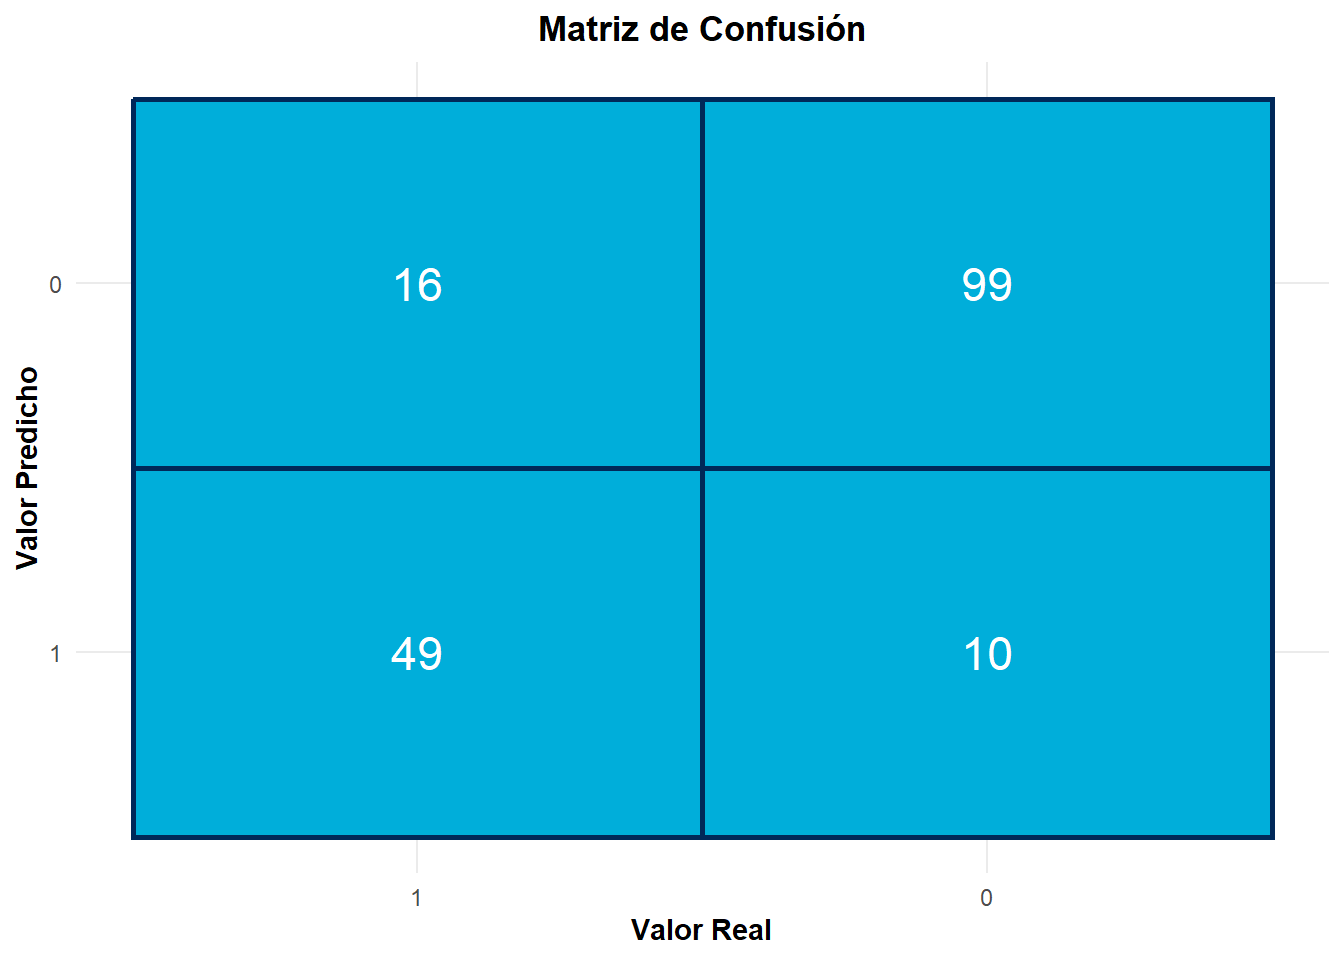
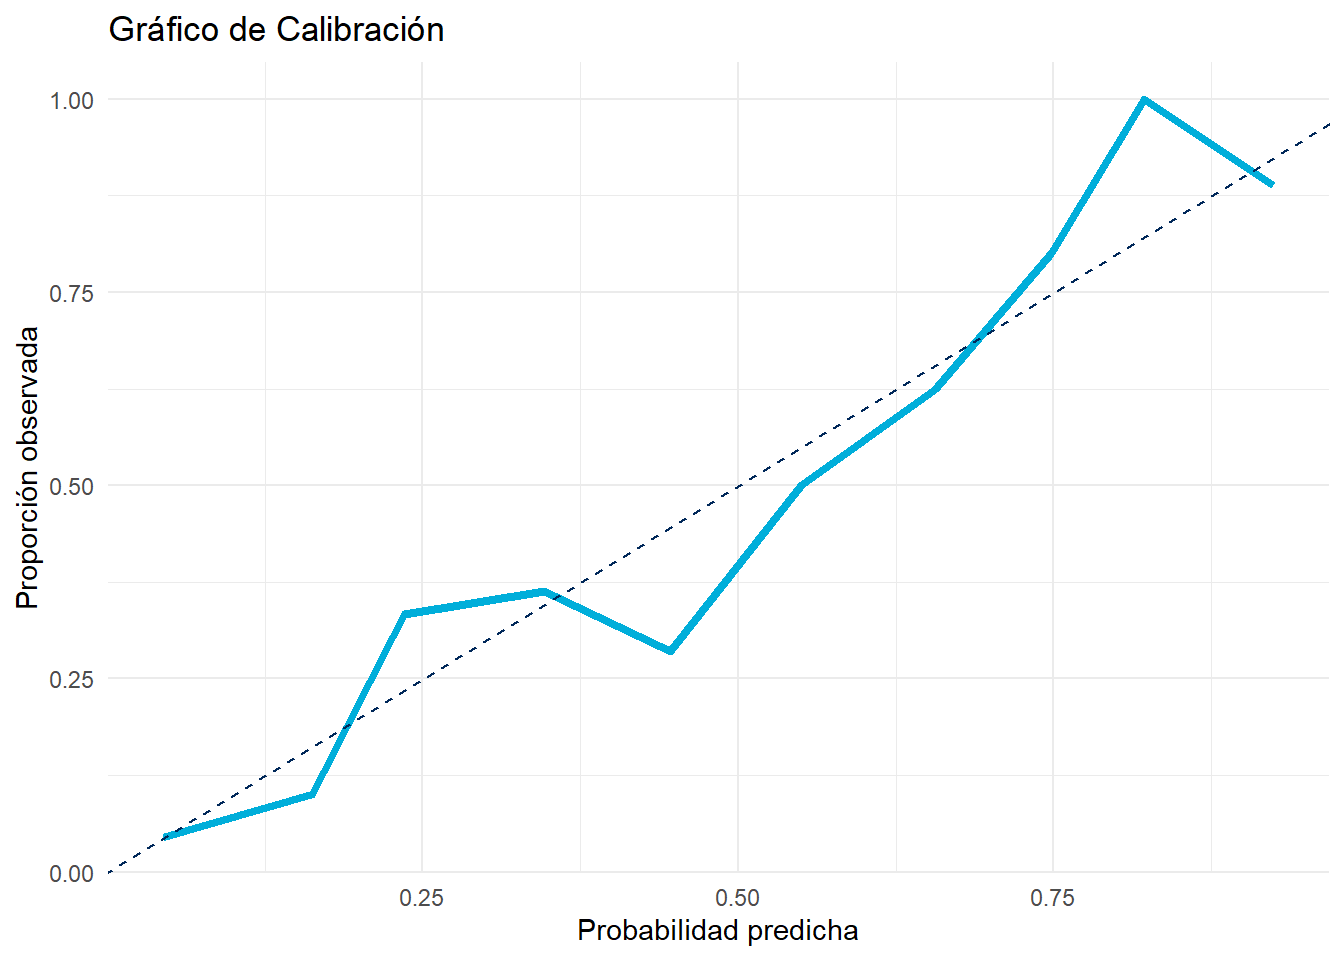
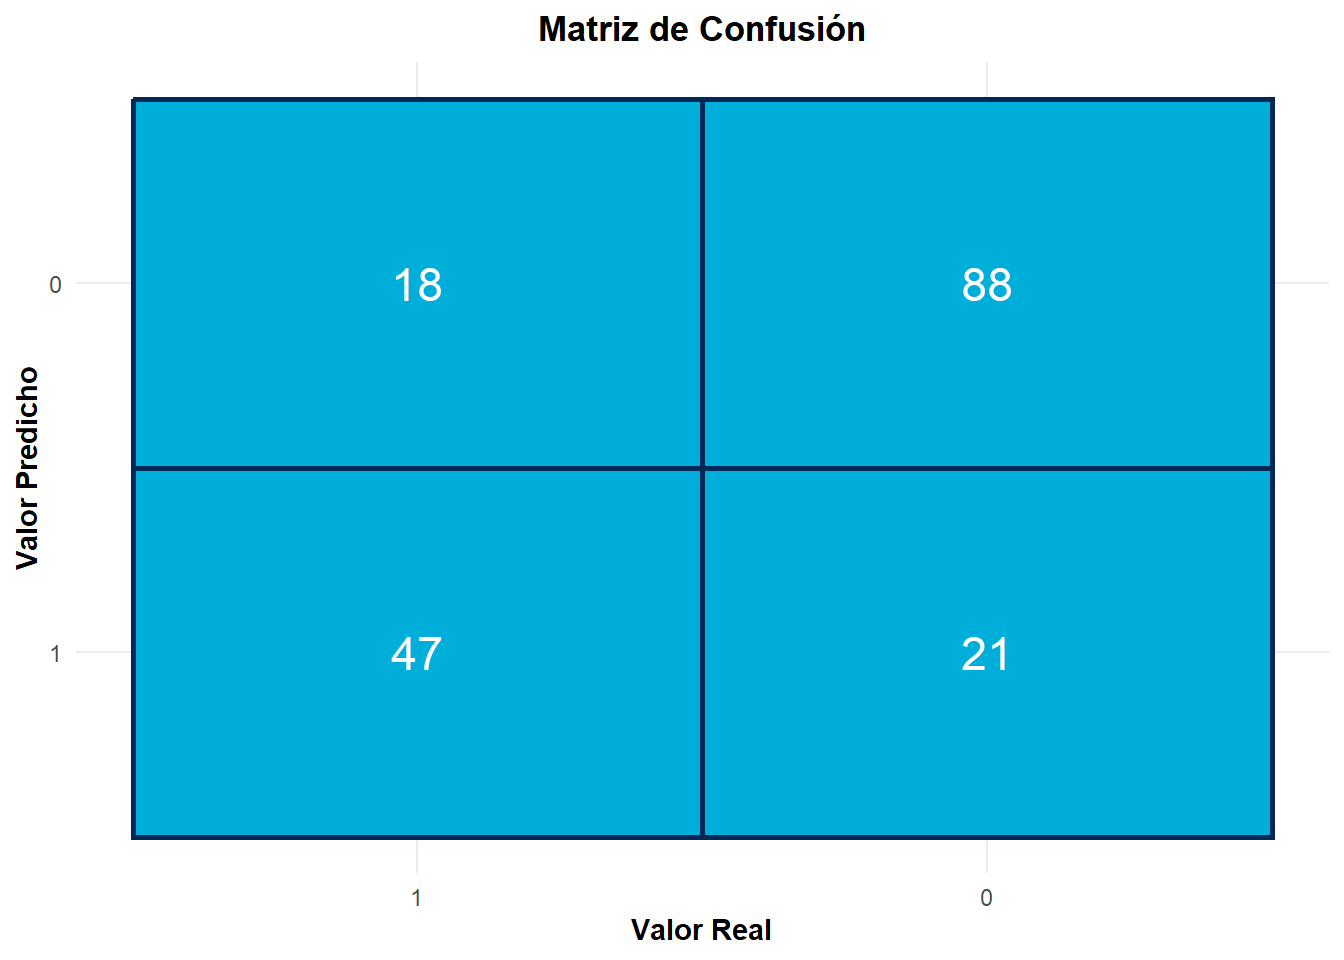
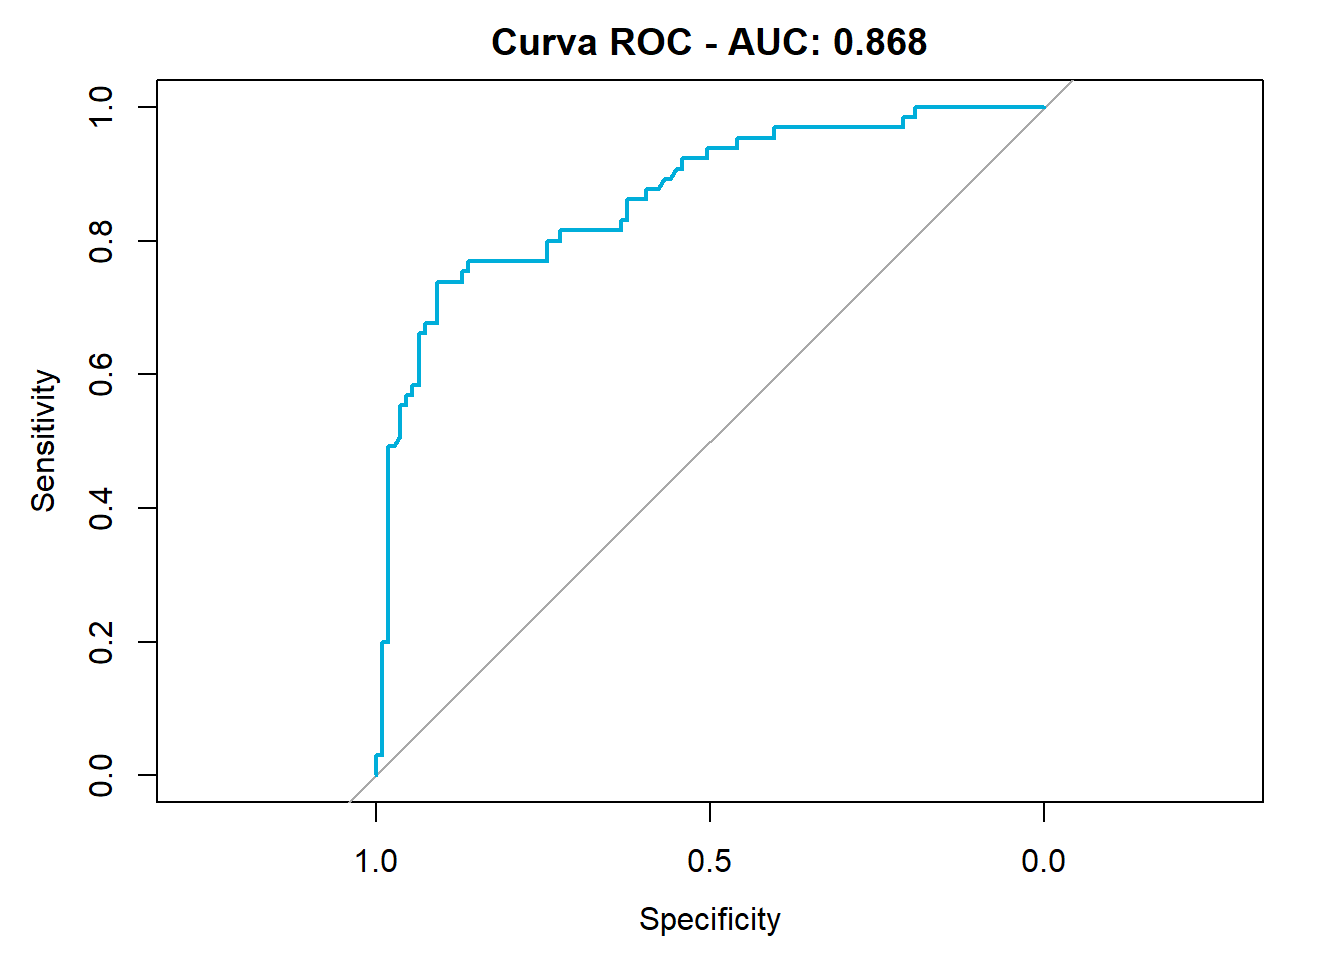
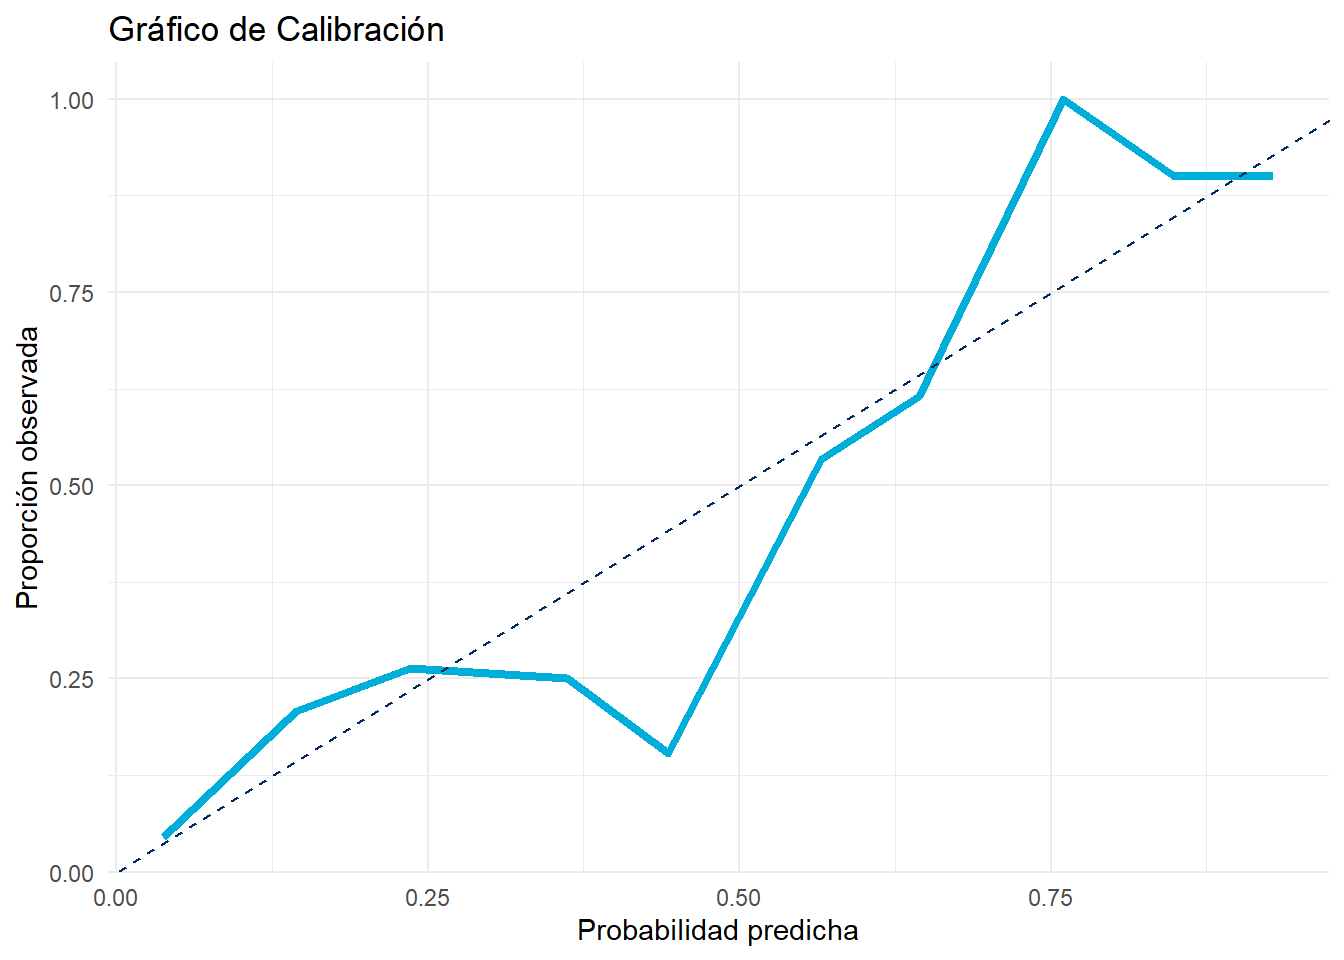
El modelo que incluye todas las variables tiene un AUC de 0.904 , el más alto de los tres. Esto sugiere que es el que mejor se ajusta a los datos; sin embargo, su complejidad también implica un mayor riesgo de overfitting , ya que puede estar capturando ruido además de señal útil, al tener más grados de libertad.
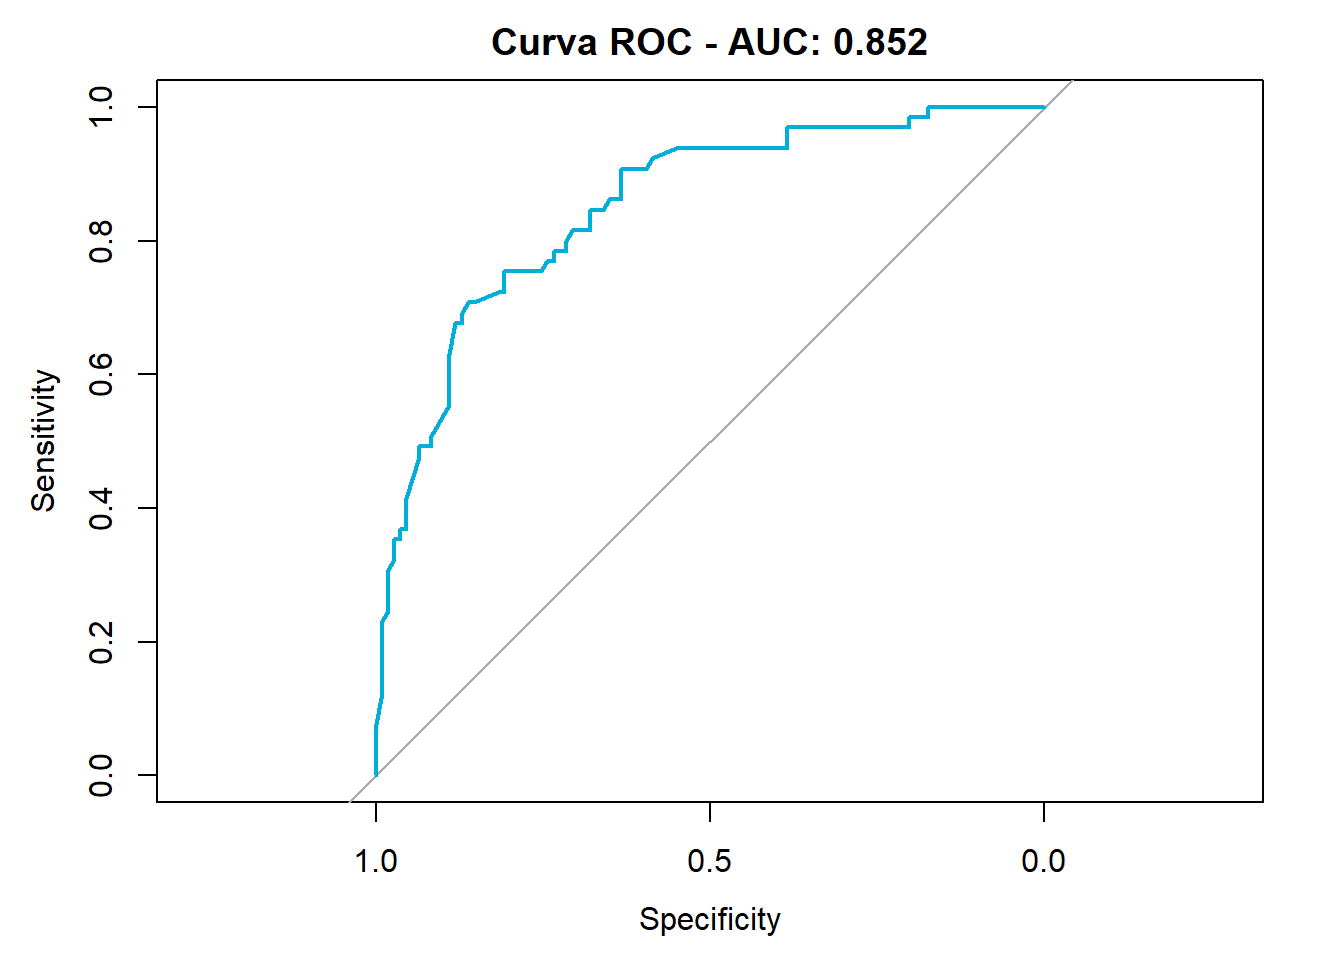
Por otro lado, los modelos obtenidos mediante forward/stepwise (AUC = 0.852) y backward (AUC = 0.868) han eliminado variables consideradas redundantes o irrelevantes según el criterio de información AIC. Estos métodos buscan modelos más simples que potencialmente generalicen mejor en nuevos datos.
La elección entre estos modelos debe balancear capacidad predictiva y simplicidad. Si desea más información sobre los métodos de selección de variables tipo wrapper , puede consultar la Sección 5.1.1
Validación con Repeated Hold-Out
Se ha creado una función que automatiza el proceso de validación utilizando la estrategia de Repeated Hold-Out. Esta función será aplicada a cada uno de los modelos especificados previamente para evaluar su capacidad de generalización.
Cabe señalar que el modelo que incluye todas las variables disponibles no será utilizado en este análisis, ya que ha demostrado generar numerosos problemas durante la fase de predicción. En concreto, se han detectado situaciones en las que aparecen clases en el conjunto de prueba que no estaban presentes en el conjunto de entrenamiento, lo que impide realizar predicciones fiables y afecta negativamente a la estabilidad del modelo. Se ha probado con técnicas de oversampling y undersampling por posibles casos de desbalance de clases, pero seguía causando el mismo tipo de error.
Aplicación del procedimiento y análisis de resultados
Forward Selection/Stepwise Regression
El modelo en cuestión tiene como fórmula final:
RCP ~ RE + QT_CAT + ESTADO_ULTIMO_CONTROL + EDAD_DIAGNOSTICO + RETRASOS
Código
<- evaluar_modelo_holdout (dataset_modelo, mod_forward, 30 , 0.75 )$ tabla:: tagList ($ plots$ acc,$ br (), tags$ br (),$ plots$ metricas,$ br (), tags$ br (),$ plots$ auc
Métricas Promedio del Repeated Holdout
acc_entrenamiento
0.7964
acc_test
0.7411
sensibilidad
0.7802
especificidad
0.6750
f1
0.7895
auc
0.7921
Código
<- evaluar_modelo_holdout (dataset_modelo, mod_forward, 30 , 0.8 )$ tabla:: tagList ($ plots$ acc,$ br (), tags$ br (),$ plots$ metricas,$ br (), tags$ br (),$ plots$ auc
Métricas Promedio del Repeated Holdout
acc_entrenamiento
0.7948
acc_test
0.7373
sensibilidad
0.7810
especificidad
0.6667
f1
0.7842
auc
0.7797
Código
<- evaluar_modelo_holdout (dataset_modelo, mod_forward, 30 , 0.9 )$ tabla:: tagList ($ plots$ acc,$ br (), tags$ br (),$ plots$ metricas,$ br (), tags$ br (),$ plots$ auc
Métricas Promedio del Repeated Holdout
acc_entrenamiento
0.7943
acc_test
0.7625
sensibilidad
0.8200
especificidad
0.6667
f1
0.8096
auc
0.7736
Código
<- evaluar_modelo_holdout (dataset_modelo, mod_forward, 20 , 0.75 )$ tabla:: tagList ($ plots$ acc,$ br (), tags$ br (),$ plots$ metricas,$ br (), tags$ br (),$ plots$ auc
Métricas Promedio del Repeated Holdout
acc_entrenamiento
0.7935
acc_test
0.7384
sensibilidad
0.7759
especificidad
0.6750
f1
0.7873
auc
0.7988
Código
<- evaluar_modelo_holdout (dataset_modelo, mod_forward, 20 , 0.8 )$ tabla:: tagList ($ plots$ acc,$ br (), tags$ br (),$ plots$ metricas,$ br (), tags$ br (),$ plots$ auc
Métricas Promedio del Repeated Holdout
acc_entrenamiento
0.7907
acc_test
0.7338
sensibilidad
0.7690
especificidad
0.6769
f1
0.7796
auc
0.7836
Código
<- evaluar_modelo_holdout (dataset_modelo, mod_forward, 20 , 0.9 )$ tabla:: tagList ($ plots$ acc,$ br (), tags$ br (),$ plots$ metricas,$ br (), tags$ br (),$ plots$ auc
Métricas Promedio del Repeated Holdout
acc_entrenamiento
0.7956
acc_test
0.7656
sensibilidad
0.8400
especificidad
0.6417
f1
0.8161
auc
0.7704
Código
<- evaluar_modelo_holdout (dataset_modelo, mod_forward, 10 , 0.75 )$ tabla:: tagList ($ plots$ acc,$ br (), tags$ br (),$ plots$ metricas,$ br (), tags$ br (),$ plots$ auc
Métricas Promedio del Repeated Holdout
acc_entrenamiento
0.7969
acc_test
0.7419
sensibilidad
0.7815
especificidad
0.6750
f1
0.7900
auc
0.8093
Código
<- evaluar_modelo_holdout (dataset_modelo, mod_forward, 10 , 0.8 )$ tabla:: tagList ($ plots$ acc,$ br (), tags$ br (),$ plots$ metricas,$ br (), tags$ br (),$ plots$ auc
Métricas Promedio del Repeated Holdout
acc_entrenamiento
0.7929
acc_test
0.7324
sensibilidad
0.7476
especificidad
0.7077
f1
0.7736
auc
0.8216
Código
<- evaluar_modelo_holdout (dataset_modelo, mod_forward, 10 , 0.9 )$ tabla:: tagList ($ plots$ acc,$ br (), tags$ br (),$ plots$ metricas,$ br (), tags$ br (),$ plots$ auc
Métricas Promedio del Repeated Holdout
acc_entrenamiento
0.7886
acc_test
0.8000
sensibilidad
0.8500
especificidad
0.7167
f1
0.8395
auc
0.8200
Backward Elimination
Tiene por modelo final:
RCP ~ EDAD_DIAGNOSTICO + TAMAÑO + Tn + RE + ESTADO_ULTIMO_CONTROL + QT_CAT
Código
<- evaluar_modelo_holdout (dataset_modelo, mod_backward, 30 , 0.75 )$ tabla:: tagList ($ plots$ acc,$ br (), tags$ br (),$ plots$ metricas,$ br (), tags$ br (),$ plots$ auc
Métricas Promedio del Repeated Holdout
acc_entrenamiento
0.8204
acc_test
0.7481
sensibilidad
0.7864
especificidad
0.6833
f1
0.7955
auc
0.8080
Código
<- evaluar_modelo_holdout (dataset_modelo, mod_backward, 30 , 0.8 )$ tabla:: tagList ($ plots$ acc,$ br (), tags$ br (),$ plots$ metricas,$ br (), tags$ br (),$ plots$ auc
Métricas Promedio del Repeated Holdout
acc_entrenamiento
0.8286
acc_test
0.7431
sensibilidad
0.8190
especificidad
0.6205
f1
0.7971
auc
0.7875
Código
<- evaluar_modelo_holdout (dataset_modelo, mod_backward, 30 , 0.9 )$ tabla:: tagList ($ plots$ acc,$ br (), tags$ br (),$ plots$ metricas,$ br (), tags$ br (),$ plots$ auc
Métricas Promedio del Repeated Holdout
acc_entrenamiento
0.8255
acc_test
0.7854
sensibilidad
0.8633
especificidad
0.6556
f1
0.8335
auc
0.7961
Código
<- evaluar_modelo_holdout (dataset_modelo, mod_backward, 20 , 0.75 )$ tabla:: tagList ($ plots$ acc,$ br (), tags$ br (),$ plots$ metricas,$ br (), tags$ br (),$ plots$ auc
Métricas Promedio del Repeated Holdout
acc_entrenamiento
0.8191
acc_test
0.7465
sensibilidad
0.7870
especificidad
0.6781
f1
0.7948
auc
0.8127
Código
<- evaluar_modelo_holdout (dataset_modelo, mod_backward, 20 , 0.8 )$ tabla:: tagList ($ plots$ acc,$ br (), tags$ br (),$ plots$ metricas,$ br (), tags$ br (),$ plots$ auc
Métricas Promedio del Repeated Holdout
acc_entrenamiento
0.8246
acc_test
0.7353
sensibilidad
0.8000
especificidad
0.6308
f1
0.7884
auc
0.7880
Código
<- evaluar_modelo_holdout (dataset_modelo, mod_backward, 20 , 0.9 )$ tabla:: tagList ($ plots$ acc,$ br (), tags$ br (),$ plots$ metricas,$ br (), tags$ br (),$ plots$ auc
Métricas Promedio del Repeated Holdout
acc_entrenamiento
0.8263
acc_test
0.7969
sensibilidad
0.8800
especificidad
0.6583
f1
0.8443
auc
0.8000
Código
<- evaluar_modelo_holdout (dataset_modelo, mod_backward, 10 , 0.75 )$ tabla:: tagList ($ plots$ acc,$ br (), tags$ br (),$ plots$ metricas,$ br (), tags$ br (),$ plots$ auc
Métricas Promedio del Repeated Holdout
acc_entrenamiento
0.8214
acc_test
0.7419
sensibilidad
0.7963
especificidad
0.6500
f1
0.7942
auc
0.8159
Código
<- evaluar_modelo_holdout (dataset_modelo, mod_backward, 10 , 0.8 )$ tabla:: tagList ($ plots$ acc,$ br (), tags$ br (),$ plots$ metricas,$ br (), tags$ br (),$ plots$ auc
Métricas Promedio del Repeated Holdout
acc_entrenamiento
0.8257
acc_test
0.7559
sensibilidad
0.8048
especificidad
0.6769
f1
0.8021
auc
0.8240
Código
<- evaluar_modelo_holdout (dataset_modelo, mod_backward, 10 , 0.9 )$ tabla:: tagList ($ plots$ acc,$ br (), tags$ br (),$ plots$ metricas,$ br (), tags$ br (),$ plots$ auc
Métricas Promedio del Repeated Holdout
acc_entrenamiento
0.8209
acc_test
0.8000
sensibilidad
0.8700
especificidad
0.6833
f1
0.8442
auc
0.8417
Con estas implementaciones del procedimiento, podemos extraer dos conclusiones clave. En primer lugar, el número óptimo de iteraciones es 30 , ya que con menos repeticiones los resultados tienden a verse más afectados por la variabilidad aleatoria, lo que reduce la fiabilidad de las métricas obtenidas. En segundo lugar, dado que el 37% de los casos en nuestro conjunto de datos corresponden a la clase positiva, es fundamental mantener un equilibrio adecuado entre los conjuntos de entrenamiento y prueba. Utilizar un 90% de los datos para entrenamiento dejaría muy pocas muestras en el conjunto de prueba, lo que dificultaría una evaluación sólida de la capacidad del modelo para generalizar, especialmente sobre la clase minoritaria. Por tanto, la proporción más adecuada es 75% para entrenamiento y 25% para prueba .
Por otro lado, el mejor modelo para continuar con el estudio resulta ser el obtenido mediante el método de Backward Elimination . Esta conclusión se basa en una comparación realizada bajo condiciones óptimas: 30 iteraciones del proceso de validación y una partición del 75% para entrenamiento y 25% para prueba. Bajo este escenario, el modelo mostró un rendimiento superior en todas las métricas clave:
Mayor precisión en ambos conjuntos.
Mayor sensibilidad significando en una mejor capacidad para detectar verdaderos positivos.
Mayor AUC que supone una excelente capacidad discriminativa global del modelo.
Búsqueda exhaustiva de predictores con evaluación honesta
Con el mejor de los modelos anteriores vamos a realizar una búsqueda exhaustiva del mejor conjunto de variables teniendo en cuenta los valores fijados de n y % .
En este caso el mejor modelo hasta ahora ha sido este que tiene como fórmula final:RCP ~ EDAD_DIAGNOSTICO + TAMAÑO + Tn + RE + ESTADO_ULTIMO_CONTROL + QT_CAT
Cabe destacar que se debe de tener en cuenta el modelo de validación honesta de las variables del modelo.
Significa que no debes usar el conjunto de test ni para seleccionar variables ni para entrenar.
En primer lugar, debemos separar los datos en conjunto de entrenamiento y prueba.
En segundo lugar, realizar la búsqueda exhaustiva sobre el conjunto de entrenamiento.
Finalmente, evaluar el mejor modelo en el conjunto de prueba.
Para esto, primeramente vamos a preparar todas las combinaciones de variables posibles.
Código
<- c ("EDAD_DIAGNOSTICO" , "TAMAÑO" , "Tn" , "RE" , "ESTADO_ULTIMO_CONTROL" , "QT_CAT" )<- list ()# Vamos a generar todas las combinaciones posibles for (i in 1 : length (variables)) {<- c (todas_combinaciones, combn (variables, i, simplify = FALSE ))
EDAD_DIAGNOSTICO
TAMAÑO
Tn
RE
ESTADO_ULTIMO_CONTROL
QT_CAT
EDAD_DIAGNOSTICO, TAMAÑO
EDAD_DIAGNOSTICO, Tn
EDAD_DIAGNOSTICO, RE
EDAD_DIAGNOSTICO, ESTADO_ULTIMO_CONTROL
EDAD_DIAGNOSTICO, QT_CAT
TAMAÑO, Tn
TAMAÑO, RE
TAMAÑO, ESTADO_ULTIMO_CONTROL
TAMAÑO, QT_CAT
Tn, RE
Tn, ESTADO_ULTIMO_CONTROL
Tn, QT_CAT
RE, ESTADO_ULTIMO_CONTROL
RE, QT_CAT
ESTADO_ULTIMO_CONTROL, QT_CAT
EDAD_DIAGNOSTICO, TAMAÑO, Tn
EDAD_DIAGNOSTICO, TAMAÑO, RE
EDAD_DIAGNOSTICO, TAMAÑO, ESTADO_ULTIMO_CONTROL
EDAD_DIAGNOSTICO, TAMAÑO, QT_CAT
EDAD_DIAGNOSTICO, Tn, RE
EDAD_DIAGNOSTICO, Tn, ESTADO_ULTIMO_CONTROL
EDAD_DIAGNOSTICO, Tn, QT_CAT
EDAD_DIAGNOSTICO, RE, ESTADO_ULTIMO_CONTROL
EDAD_DIAGNOSTICO, RE, QT_CAT
EDAD_DIAGNOSTICO, ESTADO_ULTIMO_CONTROL, QT_CAT
TAMAÑO, Tn, RE
TAMAÑO, Tn, ESTADO_ULTIMO_CONTROL
TAMAÑO, Tn, QT_CAT
TAMAÑO, RE, ESTADO_ULTIMO_CONTROL
TAMAÑO, RE, QT_CAT
TAMAÑO, ESTADO_ULTIMO_CONTROL, QT_CAT
Tn, RE, ESTADO_ULTIMO_CONTROL
Tn, RE, QT_CAT
Tn, ESTADO_ULTIMO_CONTROL, QT_CAT
RE, ESTADO_ULTIMO_CONTROL, QT_CAT
EDAD_DIAGNOSTICO, TAMAÑO, Tn, RE
EDAD_DIAGNOSTICO, TAMAÑO, Tn, ESTADO_ULTIMO_CONTROL
EDAD_DIAGNOSTICO, TAMAÑO, Tn, QT_CAT
EDAD_DIAGNOSTICO, TAMAÑO, RE, ESTADO_ULTIMO_CONTROL
EDAD_DIAGNOSTICO, TAMAÑO, RE, QT_CAT
EDAD_DIAGNOSTICO, TAMAÑO, ESTADO_ULTIMO_CONTROL, QT_CAT
EDAD_DIAGNOSTICO, Tn, RE, ESTADO_ULTIMO_CONTROL
EDAD_DIAGNOSTICO, Tn, RE, QT_CAT
EDAD_DIAGNOSTICO, Tn, ESTADO_ULTIMO_CONTROL, QT_CAT
EDAD_DIAGNOSTICO, RE, ESTADO_ULTIMO_CONTROL, QT_CAT
TAMAÑO, Tn, RE, ESTADO_ULTIMO_CONTROL
TAMAÑO, Tn, RE, QT_CAT
TAMAÑO, Tn, ESTADO_ULTIMO_CONTROL, QT_CAT
TAMAÑO, RE, ESTADO_ULTIMO_CONTROL, QT_CAT
Tn, RE, ESTADO_ULTIMO_CONTROL, QT_CAT
EDAD_DIAGNOSTICO, TAMAÑO, Tn, RE, ESTADO_ULTIMO_CONTROL
EDAD_DIAGNOSTICO, TAMAÑO, Tn, RE, QT_CAT
EDAD_DIAGNOSTICO, TAMAÑO, Tn, ESTADO_ULTIMO_CONTROL, QT_CAT
EDAD_DIAGNOSTICO, TAMAÑO, RE, ESTADO_ULTIMO_CONTROL, QT_CAT
EDAD_DIAGNOSTICO, Tn, RE, ESTADO_ULTIMO_CONTROL, QT_CAT
TAMAÑO, Tn, RE, ESTADO_ULTIMO_CONTROL, QT_CAT
EDAD_DIAGNOSTICO, TAMAÑO, Tn, RE, ESTADO_ULTIMO_CONTROL, QT_CAT
Conociendo ya todas las combinaciones posibles, vamos a evaluarlas individualmente con el método de validación utilizado anteriormente Repeated Hold Out. Como comentamos anteriormente se van a utilizar los valores óptimos predefinidos de n y % .
Código
<- list ()for (i in seq_along (todas_combinaciones)) {<- todas_combinaciones[[i]]<- as.formula (paste ("RCP ~" , paste (vars, collapse = " + " )))<- glm (formula_actual, data = dataset_modelo, family = binomial)<- evaluar_modelo_holdout (data = dataset_modelo,modelo_inicial = modelo_inicial,n_iteraciones = 30 , # número ya fijado prop_entrenamiento = 0.75 , # porcentaje ya fijado mostrar_roc = FALSE ,mostrar_tabla = FALSE <- list (variables = vars,auc = mean (res$ resultados$ auc),f1 = mean (res$ resultados$ f1),acc_test = mean (res$ resultados$ acc_test),sensibilidad = mean (res$ resultados$ sensibilidad),especificidad = mean (res$ resultados$ especificidad)
Vamos a presentar los resultados en una tabla para conseguir presentar las 5 mejores combinaciones por el valor de AUC.
Código
library (dplyr)# Paso 1: Convertimos la lista a un data.frame <- lapply (resultados, function (x) {data.frame (AUC = x$ auc,F1 = x$ f1,= x$ acc_test,Especificidad = x$ especificidad,Sensibilidad = x$ sensibilidad,= paste (x$ variables, collapse = ", " ),stringsAsFactors = FALSE %>% bind_rows () %>% arrange (desc (AUC))library (kableExtra)<- "#002859" %>% head (5 ) %>% kable (format = "html" , caption = "Top 5 combinaciones según AUC" ) %>% kable_styling (bootstrap_options = c ("striped" , "hover" ), full_width = FALSE , position = "center" ) %>% row_spec (0 , bold = TRUE , color = "white" , background = color_linea)%>% # Encabezado azul oscuro column_spec (c (1 ,2 ,3 ,4 ,5 ,6 ), background = "#00AEDA" , color = "black" )
Top 5 combinaciones según AUC
0.8080247
0.7955240
0.7480620
0.6833333
0.7864198
EDAD_DIAGNOSTICO, TAMAÑO, Tn, RE, ESTADO_ULTIMO_CONTROL, QT_CAT
0.8021219
0.7996384
0.7465116
0.6291667
0.8160494
TAMAÑO, Tn, RE, ESTADO_ULTIMO_CONTROL, QT_CAT
0.7987269
0.7812947
0.7310078
0.6687500
0.7679012
EDAD_DIAGNOSTICO, Tn, RE, ESTADO_ULTIMO_CONTROL, QT_CAT
0.7952160
0.7948657
0.7395349
0.6208333
0.8098765
Tn, RE, ESTADO_ULTIMO_CONTROL, QT_CAT
0.7842207
0.7816382
0.7341085
0.6895833
0.7604938
EDAD_DIAGNOSTICO, RE, ESTADO_ULTIMO_CONTROL, QT_CAT
Finalmente, vemos como la combinación óptima para el modelo predictivo con el uso de regresión logística es:
RCP ~ EDAD_DIAGNOSTICO, TAMAÑO, Tn, RE, ESTADO_ULTIMO_CONTROL, QT_CAT
Algoritmos de Aprendizaje Automático
A continuación, se procederá a comparar el rendimiento del modelo de regresión logística, considerado habitualmente como el gold standard en el ámbito clínico, con otros algoritmos de aprendizaje automático: Redes Neuronales (RRNN), Máquinas de Vectores de Soporte (SVM) y Árboles de Decisión (DT). Para cada uno de estos modelos se aplicarán técnicas de selección de variables tanto del tipo filtrado como wrapper , con el objetivo de identificar las características más relevantes. Asimismo, se utilizará el procedimiento de validación cruzada 5x2 CV , el cual permite una evaluación honesta de los modelos, validando tanto los hiperparámetros como las combinaciones óptimas de variables. Para la validación cruzada 5x2 CV se usará la plantilla base que se encuentra en el campus virtual.
Antes de la implementación de estos algoritmos de aprendizaje automático, como sabemos que los métodos de selección de variables son independientes a cualquier algoritmo y para no reflejar un estudio redundante, vamos a usar estas técnicas sobre el conjunto de datos para conocer estas técnicas.
Se basan en aplicar criterios estadísticos como la correlación, la información mutua o la variabilidad al conjunto de datos, en relación con la variable de interés, en nuestro caso, RCP . En este análisis, vamos a utilizar el p-valor obtenido durante el análisis bivariante para identificar qué variables presentan una relación significativa con el evento. De este modo, conseguimos reducir el conjunto de variables a aquellas que son más informativas para el modelo.
Como se mencionó al inicio de esta segunda actividad, el dataset ha sido tratado de forma distinta con respecto al utilizado en la primera, con el objetivo de obtener un análisis más adecuado. Por ello, es necesario repetir el análisis bivariante sobre este nuevo conjunto de datos para identificar las variables que presentan una relación significativa con la variable de interés .
Código
<- metodo_filtrado (dataset_recodificado, "RCP" )
Variables seleccionadas por el método de tipo Filtro
EDAD_DIAGNOSTICO
Nx
HT_ADY_OK
RE
RP
ESTADO_ULTIMO_CONTROL
GRADO_CAT
HISTOLOGIA_CAT
Ki67_CAT
FENOTIPO_IHQ_CAT
QT_CAT
Otro de los métodos de tipo wrapper que se ha utilizado en este estudio, aunque no se haya mencionado explícitamente como técnica de selección de variables, es el método de búsqueda exhaustiva. Este consiste en generar y evaluar todas las combinaciones posibles de variables para un modelo concreto. Posteriormente, se evalúa el rendimiento de cada una de estas combinaciones (por ejemplo, utilizando el AUC), con el objetivo de identificar aquellas que proporcionan el mejor desempeño predictivo.
Redes Neuronales
Código
library (caret)library (nnet)library (pROC)<- dataset_modelo<- names (data)[names (data) != "RCP" ]# Configuración de validación cruzada <- 5 <- 2 <- createFolds (data$ RCP, k = k_outer, list = FALSE )# Resultados <- numeric (k_outer)<- numeric (k_outer)<- numeric (k_outer)<- numeric (k_outer)<- 1 : nrow (data)for (i_outer in 1 : k_outer) {<- indices[folds_outer == i_outer]<- setdiff (indices, test_indices_outer)<- data[train_indices_outer, ]<- data[test_indices_outer, ]<- createFolds (datos_entrenamiento_outer$ RCP, k = k_inner, list = FALSE )<- 1 : nrow (datos_entrenamiento_outer)<- numeric (k_inner)<- numeric (k_inner)<- numeric (k_inner)<- numeric (k_inner)for (i_inner in 1 : k_inner) {<- indices_inner[folds_inner == i_inner]<- setdiff (indices_inner, test_indices_inner)<- datos_entrenamiento_outer[train_indices_inner, ]<- datos_entrenamiento_outer[test_indices_inner, ]# Hiperparámetros fijos (los mejores identificados previamente) <- 15 <- 0.001 <- 5 <- 0 # Fórmula con las variables seleccionadas <- as.formula (paste ("RCP ~" , paste (variables, collapse = "+" )))# Entrenamiento del modelo con nnet <- nnet (data = datos_entrenamiento_inner,size = size,decay = decay,maxit = maxit,skip = skip,trace = FALSE # Evaluación del AUC en el conjunto de validación <- predict (mejor_modelo, newdata = datos_validacion, type = "raw" )<- roc (ifelse (datos_validacion$ RCP == "SI" , 1 , 0 ), predicciones)<- auc (roc_obj)<- predict (mejor_modelo, newdata = datos_validacion, type = "raw" )<- ifelse (predicciones_test >= 0.5 , "SI" , "NO" )<- sum (clases_predichas == "SI" & datos_validacion$ RCP == "SI" ) / sum (datos_validacion$ RCP == "SI" )<- mean (clases_predichas == datos_validacion$ RCP)<- sum (clases_predichas == "NO" & datos_validacion$ RCP == "NO" ) / sum (datos_validacion$ RCP == "NO" )<- mejor_auc<- mean (resultados_auc_inner)<- mean (resultados_accuracy_inner)<- mean (resultados_sensibilidad_inner)<- mean (resultados_specificity_inner)# Métricas globales <- mean (resultados_auc)<- mean (resultados_accuracy)<- mean (resultados_sensibilidad)<- mean (resultados_specificity)# Tabla final <- data.frame (Pliegue = 1 : k_outer,AUC = round (resultados_auc, 3 ),Accuracy = round (resultados_accuracy, 3 ),Recall = round (resultados_sensibilidad, 3 ),Specificity = round (resultados_specificity, 3 )<- rbind (c ("Mean" , round (auc_promedio, 3 ), round (accuracy_promedio, 3 ),round (sensibilidad_promedio, 3 ), round (specificity_promedio, 3 ))# Visualización con colores personalizados library (kableExtra)kable (tabla_metricas_nnet_full, caption = "Métricas de RRNN sin Filtrado" , align = "c" ) %>% kable_styling (full_width = FALSE , font_size = 14 ,bootstrap_options = c ("striped" , "hover" , "condensed" , "responsive" )) %>% row_spec (0 , background = "#002859" , color = "white" ) %>% row_spec (1 : (nrow (tabla_metricas_nnet_full)- 1 ), background = "#00AEDA" ) %>% row_spec (nrow (tabla_metricas_nnet_full), bold = TRUE , background = "#007A99" , color = "white" )
Métricas de RRNN sin Filtrado
1
0.527
0.575
0.327
0.723
2
0.774
0.727
0.635
0.781
3
0.662
0.69
0.635
0.724
4
0.735
0.69
0.692
0.689
5
0.713
0.664
0.635
0.682
Mean
0.682
0.669
0.585
0.72
Código
# Copia del dataset original <- dataset_modelo# Extraer variables independientes <- setdiff (names (datos_iniciales), "RCP" )# Definir estructura de validación cruzada externa (5 pliegues) e interna (2 pliegues) <- 5 <- 2 <- createFolds (datos_iniciales$ RCP, k = n_folds_externos, list = FALSE )# Inicializar contenedores de métricas <- metricas_acc <- metricas_sens <- metricas_esp <- numeric (n_folds_externos)for (fold_externo in 1 : n_folds_externos) {# Separar datos de entrenamiento y prueba externa <- which (pliegues_externos == fold_externo)<- setdiff (seq_len (nrow (datos_iniciales)), idx_test_externo)<- datos_iniciales[idx_train_externo, ]<- datos_iniciales[idx_test_externo, ]# Generar pliegues internos <- createFolds (datos_train_externo$ RCP, k = n_folds_internos, list = FALSE )# Preparar métricas internas <- acc_int <- sens_int <- esp_int <- numeric (n_folds_internos)for (fold_interno in 1 : n_folds_internos) {# Filtrar variables según método externo <- metodo_filtrado (datos_train_externo, "RCP" )<- c ("RCP" , variables_seleccionadas)<- datos_train_externo[, seleccion, drop = FALSE ]<- which (pliegues_internos == fold_interno)<- setdiff (seq_len (nrow (datos_filtrados)), idx_val_interno)<- datos_filtrados[idx_entrenamiento_interno, ]<- datos_filtrados[idx_val_interno, ]# Inicializar búsqueda de mejor modelo # Hiperparámetros fijos (los mejores identificados previamente) <- 15 <- 0.001 <- 5 <- 0 # Fórmula con las variables seleccionadas <- as.formula (paste ("RCP ~" , paste (seleccion, collapse = "+" )))# Entrenamiento del modelo con nnet <- nnet (data = datos_entrenamiento_inner,size = size,decay = decay,maxit = maxit,skip = skip,trace = FALSE # Evaluación del AUC en el conjunto de validación <- predict (mejor_modelo, newdata = datos_val_interno, type = "raw" )<- roc (ifelse (datos_val_interno$ RCP == "SI" , 1 , 0 ), predicciones)<- auc (roc_obj)# Predicción final sobre conjunto de validación interno <- ifelse (predict (mejor_modelo, newdata = datos_val_interno, type = "raw" ) >= 0.5 , "SI" , "NO" )<- datos_val_interno$ RCP# Cálculo de métricas <- sum (pred_clasificacion == "SI" & real == "SI" ) / sum (real == "SI" )<- mean (pred_clasificacion == real)<- sum (pred_clasificacion == "NO" & real == "NO" ) / sum (real == "NO" )<- mejor_auc# Guardar promedios de métricas internas para el fold externo <- mean (auc_int)<- mean (acc_int)<- mean (sens_int)<- mean (esp_int)# Promedios generales <- mean (metricas_auc)<- mean (metricas_acc)<- mean (metricas_sens)<- mean (metricas_esp)# Construcción de tabla final <- data.frame (Pliegue = 1 : n_folds_externos,AUC = round (metricas_auc, 3 ),Accuracy = round (metricas_acc, 3 ),Sensibilidad = round (metricas_sens, 3 ),Especificidad = round (metricas_esp, 3 )# Agregar fila resumen <- rbind (resumen_metricas,c ("Media" , round (media_auc, 3 ), round (media_acc, 3 ), round (media_sens, 3 ), round (media_esp, 3 )))# Mostrar en formato tabla elegante kable (resumen_metricas, caption = "Métricas de RRNN con Filtrado" , align = "c" ) %>% kable_styling (bootstrap_options = c ("striped" , "hover" , "condensed" , "responsive" ),full_width = FALSE , font_size = 14 ) %>% row_spec (0 , background = "#002859" , color = "white" ) %>% row_spec (1 : (nrow (resumen_metricas)- 1 ), background = "#00AEDA" ) %>% row_spec (nrow (resumen_metricas), bold = TRUE , background = "#007A99" , color = "white" )
Métricas de RRNN con Filtrado
1
0.82
0.719
0.519
0.838
2
0.77
0.69
0.538
0.781
3
0.754
0.712
0.635
0.758
4
0.806
0.734
0.654
0.781
5
0.826
0.771
0.615
0.864
Media
0.795
0.725
0.592
0.804
Código
# Fijar semilla para reproducibilidad set.seed (123 )# Separar datos en entrenamiento (75%) y prueba (25%) <- nrow (data)<- sample (total_filas, size = floor (0.75 * total_filas))<- data[idx_train_total, ]<- data[- idx_train_total, ]# División adicional del conjunto de entrenamiento: 80% para entrenar, 20% para validar <- sample (nrow (conjunto_train), size = floor (0.8 * nrow (conjunto_train)))<- conjunto_train[idx_subtrain, ]<- conjunto_train[- idx_subtrain, ]# Inicializar resultados <- NULL <- 0 <- tibble (neurons = integer (),regularizacion = numeric (),iteraciones = integer (),salto = integer (),auc_score = numeric ()# Definir combinaciones de hiperparámetros a explorar <- expand.grid (neurons = c (5 , 15 , 20 ),regularizacion = c (0.01 , 0.5 , 0.001 ),iteraciones = c (225 , 5 , 20 , 100 ),salto = c (0 , 1 , 2 )# Crear fórmula para el modelo <- as.formula ("RCP ~ ." )# Bucle para entrenamiento con cada combinación de parámetros for (fila in 1 : nrow (rejilla_parametros)) {<- rejilla_parametros[fila, ]<- nnet (formula = modelo_formula,data = datos_train,size = h$ neurons,decay = h$ regularizacion,maxit = h$ iteraciones,skip = h$ salto,trace = FALSE # Predicción en conjunto de prueba <- predict (red, newdata = conjunto_test, type = "raw" )# Calcular AUC <- ifelse (conjunto_test$ RCP == "SI" , 1 , 0 )<- roc (etiquetas, pred_prob)<- as.numeric (auc (curva_roc))# Registrar resultados <- historial_resultados %>% add_row (neurons = h$ neurons,regularizacion = h$ regularizacion,iteraciones = h$ iteraciones,salto = h$ salto,auc_score = valor_auc# Actualizar el mejor modelo if (valor_auc > mayor_auc) {<- valor_auc<- red# Resultados ordenados por AUC <- historial_resultados %>% arrange (desc (auc_score))%>% mutate (AUC = round (auc_score, 3 )) %>% kable ("html" , caption = "Resumen de combinaciones de hiperparámetros evaluadas con RRNN" , align = "c" ) %>% kable_styling (full_width = TRUE , bootstrap_options = c ("striped" , "hover" , "condensed" )) %>% row_spec (0 , background = "#002859" , color = "white" ) %>% row_spec (1 : nrow (mejores_modelos), background = "#00AEDA" , color = "black" ) %>% scroll_box ( height = "400px" , fixed_thead = TRUE )
Resumen de combinaciones de hiperparámetros evaluadas con RRNN
15
0.001
5
0
0.8958333
0.896
15
0.001
5
1
0.8697917
0.870
15
0.001
225
0
0.8645833
0.865
15
0.001
100
0
0.8645833
0.865
20
0.500
5
0
0.8619792
0.862
5
0.500
225
0
0.8593750
0.859
5
0.500
100
0
0.8593750
0.859
20
0.010
5
2
0.8593750
0.859
5
0.001
5
0
0.8567708
0.857
5
0.500
20
0
0.8541667
0.854
15
0.500
20
0
0.8541667
0.854
20
0.500
20
0
0.8541667
0.854
20
0.010
100
0
0.8541667
0.854
15
0.500
5
1
0.8541667
0.854
15
0.500
225
0
0.8515625
0.852
20
0.500
225
0
0.8515625
0.852
5
0.500
5
0
0.8515625
0.852
15
0.500
100
0
0.8515625
0.852
20
0.500
100
0
0.8515625
0.852
5
0.500
5
1
0.8489583
0.849
20
0.001
5
2
0.8489583
0.849
20
0.010
100
2
0.8489583
0.849
20
0.001
5
0
0.8463542
0.846
5
0.500
225
1
0.8463542
0.846
15
0.500
225
1
0.8463542
0.846
20
0.500
225
1
0.8463542
0.846
5
0.500
20
1
0.8463542
0.846
20
0.500
20
1
0.8463542
0.846
5
0.500
100
1
0.8463542
0.846
15
0.500
100
1
0.8463542
0.846
20
0.500
100
1
0.8463542
0.846
5
0.500
225
2
0.8463542
0.846
15
0.500
225
2
0.8463542
0.846
20
0.500
225
2
0.8463542
0.846
15
0.500
20
2
0.8463542
0.846
20
0.500
20
2
0.8463542
0.846
5
0.500
100
2
0.8463542
0.846
15
0.500
100
2
0.8463542
0.846
20
0.500
100
2
0.8463542
0.846
20
0.001
225
0
0.8437500
0.844
15
0.500
20
1
0.8437500
0.844
20
0.010
20
0
0.8411458
0.841
20
0.010
225
1
0.8411458
0.841
15
0.010
5
0
0.8385417
0.839
15
0.010
20
0
0.8385417
0.839
20
0.010
5
1
0.8385417
0.839
20
0.001
225
2
0.8359375
0.836
5
0.500
20
2
0.8359375
0.836
5
0.010
20
1
0.8333333
0.833
20
0.001
100
1
0.8307292
0.831
20
0.001
20
2
0.8307292
0.831
20
0.001
225
1
0.8281250
0.828
5
0.010
5
1
0.8281250
0.828
15
0.001
100
1
0.8281250
0.828
15
0.001
5
2
0.8229167
0.823
15
0.001
100
2
0.8229167
0.823
5
0.010
225
0
0.8203125
0.820
20
0.010
225
0
0.8203125
0.820
5
0.001
100
2
0.8190104
0.819
15
0.010
20
1
0.8177083
0.818
5
0.010
100
1
0.8177083
0.818
15
0.010
225
0
0.8151042
0.815
5
0.010
100
0
0.8151042
0.815
20
0.010
225
2
0.8151042
0.815
5
0.500
5
2
0.8151042
0.815
5
0.010
100
2
0.8151042
0.815
15
0.500
5
0
0.8125000
0.812
15
0.010
5
1
0.8072917
0.807
15
0.010
100
1
0.8072917
0.807
5
0.001
100
1
0.8072917
0.807
5
0.001
5
2
0.8072917
0.807
20
0.010
20
2
0.8072917
0.807
15
0.010
100
0
0.8046875
0.805
20
0.001
5
1
0.8046875
0.805
20
0.010
20
1
0.8046875
0.805
15
0.001
225
2
0.8046875
0.805
5
0.001
20
0
0.8020833
0.802
5
0.010
225
1
0.8020833
0.802
5
0.010
225
2
0.8020833
0.802
5
0.001
225
1
0.7994792
0.799
15
0.001
225
1
0.7994792
0.799
20
0.010
100
1
0.7994792
0.799
15
0.500
5
2
0.7968750
0.797
5
0.010
20
2
0.7968750
0.797
20
0.001
100
2
0.7968750
0.797
20
0.001
20
0
0.7942708
0.794
20
0.001
100
0
0.7916667
0.792
20
0.001
20
1
0.7916667
0.792
15
0.010
100
2
0.7916667
0.792
5
0.010
5
0
0.7890625
0.789
20
0.010
5
0
0.7890625
0.789
15
0.010
225
1
0.7890625
0.789
15
0.010
225
2
0.7864583
0.786
5
0.001
100
0
0.7812500
0.781
5
0.001
225
2
0.7812500
0.781
15
0.010
20
2
0.7786458
0.779
15
0.001
20
1
0.7773438
0.777
5
0.001
225
0
0.7760417
0.776
20
0.500
5
1
0.7760417
0.776
15
0.010
5
2
0.7760417
0.776
5
0.001
5
1
0.7734375
0.773
15
0.001
20
2
0.7708333
0.771
5
0.001
20
1
0.7656250
0.766
20
0.500
5
2
0.7578125
0.758
5
0.010
5
2
0.7500000
0.750
15
0.001
20
0
0.7265625
0.727
5
0.001
20
2
0.7148438
0.715
5
0.010
20
0
0.6588542
0.659
Máquinas de Vectores de Soporte
Código
# Configurar validación cruzada externa (5x2) set.seed (123 )<- 5 <- 2 <- createFolds (data$ RCP, k = pliegues_externos, list = FALSE )<- nrow (data)# Inicializar vectores para resultados <- numeric (pliegues_externos)<- numeric (pliegues_externos)<- numeric (pliegues_externos)<- numeric (pliegues_externos)# Matrices para predicciones y valores reales <- matrix (NA , nrow = n, ncol = pliegues_externos)<- numeric (n)# Bucle principal de validación cruzada externa for (fold_idx in 1 : pliegues_externos) {<- which (folds_externos == fold_idx)<- setdiff (1 : n, test_idx)<- data[train_idx, ]<- data[test_idx, ]# Validación cruzada interna para selección de modelo <- createFolds (train_data$ RCP, k = pliegues_internos, list = FALSE )<- data.frame (auc = numeric (pliegues_internos),acc = numeric (pliegues_internos),recall = numeric (pliegues_internos),specificity = numeric (pliegues_internos))for (inner_idx in 1 : pliegues_internos) {<- which (inner_folds == inner_idx)<- setdiff (1 : nrow (train_data), val_idx)<- train_data[subtrain_idx, ]<- train_data[val_idx, ]<- - Inf <- NULL # Hiperparámetros óptimos identificados previamente <- "radial" <- 100 <- 0.1 # Entrenar el modelo SVM con esos hiperparámetros <- svm (RCP ~ ., data = train_inner, type = "C-classification" ,kernel = kernel_opt, cost = cost_opt, gamma = gamma_opt, probability = TRUE )# Predecir probabilidades <- attr (predict (best_model, newdata = val_inner, probability = TRUE ), "probabilities" )[, "SI" ]<- ifelse (prob_val >= 0.85 , "SI" , "NO" )# Métricas de evaluación <- sum (pred_class == "SI" & val_inner$ RCP == "SI" )<- sum (pred_class == "NO" & val_inner$ RCP == "NO" )<- sum (pred_class == "SI" & val_inner$ RCP == "NO" )<- sum (pred_class == "NO" & val_inner$ RCP == "SI" )<- TP / (TP + FN)<- (TP + TN) / (TP + TN + FP + FN)<- TN / (TN + FP)<- 0.8 * recall + 0.2 * acc# Calcular el AUC <- auc (roc (ifelse (val_inner$ RCP == "SI" , 1 , 0 ), prob_val))$ auc[inner_idx] <- auc_val$ acc[inner_idx] <- acc$ recall[inner_idx] <- recall$ specificity[inner_idx] <- specificity# Evaluar en conjunto de test externo <- attr (predict (best_model, newdata = test_data, probability = TRUE ), "probabilities" )[, "SI" ]<- ifelse (final_prob >= 0.5 , "SI" , "NO" )<- sum (final_class == "SI" & test_data$ RCP == "SI" )<- sum (final_class == "NO" & test_data$ RCP == "NO" )<- sum (final_class == "SI" & test_data$ RCP == "NO" )<- sum (final_class == "NO" & test_data$ RCP == "SI" )<- auc (roc (ifelse (test_data$ RCP == "SI" , 1 , 0 ), final_prob))<- (TP + TN) / (TP + TN + FP + FN)<- TP / (TP + FN)<- TN / (TN + FP)<- final_prob<- ifelse (test_data$ RCP == "SI" , 1 , 0 )# Tabla de resultados por pliegue <- data.frame (Fold = 1 : pliegues_externos,AUC = round (auc_scores, 3 ),Accuracy = round (accuracy_scores, 3 ),Recall = round (recall_scores, 3 ),Specificity = round (specificity_scores, 3 )# Agregar fila de promedios <- data.frame (Fold = "Mean" ,AUC = round (mean (auc_scores), 3 ),Accuracy = round (mean (accuracy_scores), 3 ),Recall = round (mean (recall_scores), 3 ),Specificity = round (mean (specificity_scores), 3 )<- rbind (tabla_resultados, promedios)# Mostrar tabla con estilo, colores y scroll %>% kable ("html" , caption = "Métricas de SVM sin Filtrado" , align = "c" ) %>% kable_styling (full_width = TRUE , bootstrap_options = c ("striped" , "hover" , "condensed" )) %>% row_spec (0 , background = "#002859" , color = "white" ) %>% row_spec (1 : (nrow (tabla_final) - 1 ), background = "#00AEDA" , color = "black" ) %>% row_spec (nrow (tabla_final), background = "#007A99" , color = "white" , bold = TRUE )
Métricas de SVM sin Filtrado
1
0.773
0.706
0.692
0.714
2
0.619
0.743
0.308
1.000
3
0.860
0.886
0.846
0.909
4
0.755
0.714
0.462
0.864
5
0.615
0.743
0.385
0.955
Mean
0.725
0.758
0.538
0.888
Código
# Configurar validación cruzada externa (5x2) set.seed (123 )<- 5 <- 2 <- createFolds (data$ RCP, k = pliegues_externos, list = FALSE )<- nrow (data)# Inicializar vectores para resultados <- numeric (pliegues_externos)<- numeric (pliegues_externos)<- numeric (pliegues_externos)<- numeric (pliegues_externos)# Matrices para predicciones y valores reales <- matrix (NA , nrow = n, ncol = pliegues_externos)<- numeric (n)# Bucle principal de validación cruzada externa for (fold_idx in 1 : pliegues_externos) {<- which (folds_externos == fold_idx)<- setdiff (1 : n, test_idx)<- data[train_idx, ]<- data[test_idx, ]# Validación cruzada interna para selección de modelo <- createFolds (train_data$ RCP, k = pliegues_internos, list = FALSE )<- data.frame (auc = numeric (pliegues_internos),acc = numeric (pliegues_internos),recall = numeric (pliegues_internos),specificity = numeric (pliegues_internos))<- NULL <- - Inf for (inner_idx in 1 : pliegues_internos) {<- which (inner_folds == inner_idx)<- setdiff (1 : nrow (train_data), val_idx)<- train_data[subtrain_idx, ]<- train_data[val_idx, ]# Filtrado de variables <- metodo_filtrado (train_inner, "RCP" )<- c ("RCP" , variables_seleccionadas)<- train_inner[, vars, drop = FALSE ]<- val_inner[, vars, drop = FALSE ]# Hiperparámetros óptimos <- "radial" <- 100 <- 0.1 # Entrenar modelo <- svm (RCP ~ ., data = train_inner, type = "C-classification" ,kernel = kernel_opt, cost = cost_opt, gamma = gamma_opt, probability = TRUE )# Validación <- attr (predict (best_model_fold, newdata = val_inner, probability = TRUE ), "probabilities" )[, "SI" ]<- ifelse (prob_val >= 0.85 , "SI" , "NO" )<- sum (pred_class == "SI" & val_inner$ RCP == "SI" )<- sum (pred_class == "NO" & val_inner$ RCP == "NO" )<- sum (pred_class == "SI" & val_inner$ RCP == "NO" )<- sum (pred_class == "NO" & val_inner$ RCP == "SI" )<- TP / (TP + FN)<- (TP + TN) / (TP + TN + FP + FN)<- TN / (TN + FP)<- 0.8 * recall + 0.2 * acc<- auc (roc (ifelse (val_inner$ RCP == "SI" , 1 , 0 ), prob_val))$ auc[inner_idx] <- auc_val$ acc[inner_idx] <- acc$ recall[inner_idx] <- recall$ specificity[inner_idx] <- specificityif (custom_score > best_score_global) {<- custom_score<- best_model_fold<- variables_seleccionadas# Evaluación en test externo con el mejor modelo encontrado <- test_data[, c ("RCP" , best_vars), drop = FALSE ]<- attr (predict (best_model, newdata = test_data_filtrado, probability = TRUE ), "probabilities" )[, "SI" ]<- ifelse (final_prob >= 0.5 , "SI" , "NO" )<- sum (final_class == "SI" & test_data_filtrado$ RCP == "SI" )<- sum (final_class == "NO" & test_data_filtrado$ RCP == "NO" )<- sum (final_class == "SI" & test_data_filtrado$ RCP == "NO" )<- sum (final_class == "NO" & test_data_filtrado$ RCP == "SI" )<- auc (roc (ifelse (test_data_filtrado$ RCP == "SI" , 1 , 0 ), final_prob))<- (TP + TN) / (TP + TN + FP + FN)<- TP / (TP + FN)<- TN / (TN + FP)<- final_prob<- ifelse (test_data$ RCP == "SI" , 1 , 0 )# Tabla de resultados por pliegue <- data.frame (Fold = 1 : pliegues_externos,AUC = round (auc_scores, 3 ),Accuracy = round (accuracy_scores, 3 ),Recall = round (recall_scores, 3 ),Specificity = round (specificity_scores, 3 )# Fila de promedios <- data.frame (Fold = "Mean" ,AUC = round (mean (auc_scores), 3 ),Accuracy = round (mean (accuracy_scores), 3 ),Recall = round (mean (recall_scores), 3 ),Specificity = round (mean (specificity_scores), 3 )<- rbind (tabla_resultados, promedios)# Mostrar tabla %>% kable ("html" , caption = "Métricas de SVM con Filtrado" , align = "c" ) %>% kable_styling (full_width = TRUE , bootstrap_options = c ("striped" , "hover" , "condensed" )) %>% row_spec (0 , background = "#002859" , color = "white" ) %>% row_spec (1 : (nrow (tabla_final) - 1 ), background = "#00AEDA" , color = "black" ) %>% row_spec (nrow (tabla_final), background = "#007A99" , color = "white" , bold = TRUE )
Métricas de SVM con Filtrado
1
0.593
0.618
0.385
0.762
2
0.687
0.714
0.462
0.864
3
0.850
0.771
0.385
1.000
4
0.654
0.543
0.385
0.636
5
0.762
0.771
0.769
0.773
Mean
0.709
0.684
0.477
0.807
Código
# Dividir el conjunto de datos en entrenamiento y test set.seed (123 )<- sample (nrow (data), 0.75 * nrow (data))<- data[indices_entrenamiento, ]<- data[- indices_entrenamiento, ]# Dividir datos de entrenamiento en entrenamiento y validación <- sample (nrow (datos_entrenamiento), 0.8 * nrow (datos_entrenamiento))<- datos_entrenamiento[train_indices, ]<- datos_entrenamiento[- train_indices, ]# Inicializar resultados <- 0 <- NULL <- data.frame (kernel = character (), cost = numeric (), gamma = numeric (), auc = numeric (), stringsAsFactors = FALSE )# Definir hiperparámetros <- expand.grid (cost = c (100 , 1000 , 10000 , 50000 , 1000000 ),gamma = c (0.1 , 1 , 10 ),kernel = c ("linear" , "radial" , "sigmoid" ))# Entrenar y evaluar modelos for (i in 1 : nrow (params)) {<- svm (RCP ~ ., data = datos_entrenamiento_split,type = "C-classification" ,kernel = params$ kernel[i],cost = params$ cost[i],gamma = params$ gamma[i],probability = TRUE )<- predict (modelo, newdata = datos_test, probability = TRUE )<- attr (predicciones_test, "probabilities" )[, "SI" ]<- roc (ifelse (datos_test$ RCP == "SI" , 1 , 0 ), probabilidades_test)<- as.numeric (auc (roc_obj))<- resultados %>% add_row (kernel = params$ kernel[i], cost = params$ cost[i], gamma = params$ gamma[i], auc = auc_actual)if (auc_actual > mejor_auc) {<- auc_actual<- modelo# Ordenar resultados <- resultados %>% arrange (desc (auc))# Mostrar tabla estilizada %>% mutate (across (where (is.numeric), round, 4 )) %>% kable ("html" , caption = "Resumen de combinaciones de hiperparámetros evaluadas con SVM" , align = "c" ) %>% kable_styling (full_width = TRUE , bootstrap_options = c ("striped" , "hover" , "condensed" )) %>% row_spec (0 , background = "#002859" , color = "white" ) %>% row_spec (1 : nrow (resultados_ordenados_svm), background = "#00AEDA" , color = "black" ) %>% scroll_box ( height = "400px" , fixed_thead = TRUE )
Resumen de combinaciones de hiperparámetros evaluadas con SVM
radial
1e+02
0.1
0.8906
radial
1e+03
0.1
0.8906
radial
1e+04
0.1
0.8906
radial
5e+04
0.1
0.8906
radial
1e+06
0.1
0.8906
radial
1e+02
1.0
0.8490
radial
1e+03
1.0
0.8490
radial
1e+04
1.0
0.8490
radial
5e+04
1.0
0.8490
radial
1e+06
1.0
0.8490
linear
1e+06
0.1
0.8411
linear
1e+06
1.0
0.8411
linear
1e+06
10.0
0.8411
linear
1e+04
0.1
0.7708
linear
1e+04
1.0
0.7708
linear
1e+04
10.0
0.7708
linear
1e+03
0.1
0.7656
linear
1e+03
1.0
0.7656
linear
1e+03
10.0
0.7656
linear
1e+02
0.1
0.7630
linear
1e+02
1.0
0.7630
linear
1e+02
10.0
0.7630
linear
5e+04
0.1
0.7604
linear
5e+04
1.0
0.7604
linear
5e+04
10.0
0.7604
sigmoid
1e+02
0.1
0.7188
sigmoid
1e+03
0.1
0.5938
sigmoid
1e+04
0.1
0.5938
sigmoid
5e+04
0.1
0.5938
sigmoid
1e+06
0.1
0.5938
sigmoid
1e+02
1.0
0.5286
sigmoid
1e+03
1.0
0.5286
sigmoid
1e+04
1.0
0.5286
sigmoid
5e+04
1.0
0.5286
sigmoid
1e+06
1.0
0.5286
sigmoid
1e+04
10.0
0.4844
sigmoid
5e+04
10.0
0.4844
sigmoid
1e+02
10.0
0.4740
sigmoid
1e+03
10.0
0.4740
sigmoid
1e+06
10.0
0.4740
radial
1e+02
10.0
0.3242
radial
1e+06
10.0
0.3242
radial
1e+03
10.0
0.2917
radial
1e+04
10.0
0.2917
radial
5e+04
10.0
0.2917
Árboles de Decisión
Código
# Validación cruzada 5x2 set.seed (123 )<- 5 <- 2 <- createFolds (data$ RCP, k = k_outer, list = FALSE )<- 1 : nrow (data)# Inicializar métricas <- numeric (k_outer)<- numeric (k_outer)<- numeric (k_outer)<- numeric (k_outer)# Iterar por cada pliegue externo for (i_outer in 1 : k_outer) {<- indices[folds_outer == i_outer]<- setdiff (indices, test_indices_outer)<- data[train_indices_outer, ]<- data[test_indices_outer, ]<- createFolds (train_outer$ RCP, k = k_inner, list = FALSE )<- numeric (k_inner)<- numeric (k_inner)<- numeric (k_inner)<- numeric (k_inner)for (i_inner in 1 : k_inner) {<- which (folds_inner == i_inner)<- setdiff (1 : nrow (train_outer), test_indices_inner)<- train_outer[train_indices_inner, ]<- train_outer[test_indices_inner, ]# Búsqueda de hiperparámetros <- expand.grid (cp = c (0.01 , 0.05 , 0.1 ),minsplit = c (5 , 10 , 20 ),minbucket = c (5 , 10 , 20 ))<- 0 <- NULL for (params in 1 : nrow (param_grid)) {<- param_grid$ cp[params]<- param_grid$ minsplit[params]<- param_grid$ minbucket[params]<- rpart (RCP ~ ., data = train_inner,method = "class" ,control = rpart.control (cp = cp, minsplit = minsplit, minbucket = minbucket))<- predict (modelo, newdata = val_inner, type = "prob" )[, "SI" ]<- roc (val_inner$ RCP, prob, levels = rev (levels (val_inner$ RCP)))<- auc (roc_obj)if (auc_val > mejor_auc) {<- auc_val<- modelo# Evaluar modelo en validación interna <- predict (mejor_modelo, newdata = val_inner, type = "prob" )[, "SI" ]<- ifelse (prob >= 0.85 , "SI" , "NO" )<- sum (pred == "SI" & val_inner$ RCP == "SI" )<- sum (pred == "NO" & val_inner$ RCP == "SI" )<- sum (pred == "SI" & val_inner$ RCP == "NO" )<- sum (pred == "NO" & val_inner$ RCP == "NO" )<- TP / (TP + FN)<- (TP + TN) / (TP + TN + FP + FN)<- TN / (TN + FP)<- mejor_auc<- accuracy<- recall<- specificity<- mean (resultados_auc_inner)<- mean (resultados_accuracy_inner)<- mean (resultados_sensibilidad_inner)<- mean (resultados_specificity_inner)# Construir tabla de resultados <- data.frame (Pliegue = 1 : k_outer,AUC = round (resultados_auc, 3 ),Accuracy = round (resultados_accuracy, 3 ),Recall = round (resultados_sensibilidad, 3 ),Specificity = round (resultados_specificity, 3 )# Agregar promedio <- rbind (tabla_metricas, data.frame (Pliegue = "Mean" ,AUC = round (mean (resultados_auc), 3 ),Accuracy = round (mean (resultados_accuracy), 3 ),Recall = round (mean (resultados_sensibilidad), 3 ),Specificity = round (mean (resultados_specificity), 3 )%>% kable ("html" , caption = "Métricas de DT sin Filtrado" ) %>% kable_styling (full_width = TRUE , bootstrap_options = c ("striped" , "hover" , "condensed" )) %>% row_spec (0 , background = "#002859" , color = "white" ) %>% row_spec (1 : (nrow (tabla_metricas)- 1 ), background = "#00AEDA" ) %>% row_spec (nrow (tabla_metricas), background = "#007A99" , color = "white" , bold = TRUE )
Métricas de DT sin Filtrado
1
0.524
0.529
0.192
0.727
2
0.620
0.669
0.212
0.942
3
0.683
0.633
0.096
0.955
4
0.588
0.626
0.154
0.907
5
0.675
0.691
0.462
0.828
Mean
0.618
0.630
0.223
0.872
Código
# Validación cruzada 5x2 set.seed (123 )<- 5 <- 2 <- createFolds (data$ RCP, k = k_outer, list = FALSE )<- 1 : nrow (data)# Inicializar métricas <- numeric (k_outer)<- numeric (k_outer)<- numeric (k_outer)<- numeric (k_outer)# Iterar por cada pliegue externo for (i_outer in 1 : k_outer) {<- indices[folds_outer == i_outer]<- setdiff (indices, test_indices_outer)<- data[train_indices_outer, ]<- data[test_indices_outer, ]<- createFolds (train_outer$ RCP, k = k_inner, list = FALSE )<- numeric (k_inner)<- numeric (k_inner)<- numeric (k_inner)<- numeric (k_inner)for (i_inner in 1 : k_inner) {<- which (folds_inner == i_inner)<- setdiff (1 : nrow (train_outer), test_indices_inner)<- train_outer[train_indices_inner, ]<- train_outer[test_indices_inner, ]<- metodo_filtrado (train_inner, "RCP" )<- c ("RCP" , variables_seleccionadas)<- train_inner[, vars, drop = FALSE ]<- val_inner[, vars, drop = FALSE ]# Búsqueda de hiperparámetros <- expand.grid (cp = c (0.01 , 0.05 , 0.1 ),minsplit = c (5 , 10 , 20 ),minbucket = c (5 , 10 , 20 ))<- 0 <- NULL for (params in 1 : nrow (param_grid)) {<- param_grid$ cp[params]<- param_grid$ minsplit[params]<- param_grid$ minbucket[params]<- rpart (RCP ~ ., data = train_inner,method = "class" ,control = rpart.control (cp = cp, minsplit = minsplit, minbucket = minbucket))<- predict (modelo, newdata = val_inner, type = "prob" )[, "SI" ]<- roc (val_inner$ RCP, prob, levels = rev (levels (val_inner$ RCP)))<- auc (roc_obj)if (auc_val > mejor_auc) {<- auc_val<- modelo# Evaluar modelo en validación interna <- predict (mejor_modelo, newdata = val_inner, type = "prob" )[, "SI" ]<- ifelse (prob >= 0.85 , "SI" , "NO" )<- sum (pred == "SI" & val_inner$ RCP == "SI" )<- sum (pred == "NO" & val_inner$ RCP == "SI" )<- sum (pred == "SI" & val_inner$ RCP == "NO" )<- sum (pred == "NO" & val_inner$ RCP == "NO" )<- TP / (TP + FN)<- (TP + TN) / (TP + TN + FP + FN)<- TN / (TN + FP)<- mejor_auc<- accuracy<- recall<- specificity<- mean (resultados_auc_inner)<- mean (resultados_accuracy_inner)<- mean (resultados_sensibilidad_inner)<- mean (resultados_specificity_inner)# Construir tabla de resultados <- data.frame (Pliegue = 1 : k_outer,AUC = round (resultados_auc, 3 ),Accuracy = round (resultados_accuracy, 3 ),Recall = round (resultados_sensibilidad, 3 ),Specificity = round (resultados_specificity, 3 )# Agregar promedio <- rbind (tabla_metricas, data.frame (Pliegue = "Mean" ,AUC = round (mean (resultados_auc), 3 ),Accuracy = round (mean (resultados_accuracy), 3 ),Recall = round (mean (resultados_sensibilidad), 3 ),Specificity = round (mean (resultados_specificity), 3 )%>% kable ("html" , caption = "Métricas de DT con Filtrado" ) %>% kable_styling (full_width = TRUE , bootstrap_options = c ("striped" , "hover" , "condensed" )) %>% row_spec (0 , background = "#002859" , color = "white" ) %>% row_spec (1 : (nrow (tabla_metricas)- 1 ), background = "#00AEDA" ) %>% row_spec (nrow (tabla_metricas), background = "#007A99" , color = "white" , bold = TRUE )
Métricas de DT con Filtrado
1
0.550
0.664
0.115
0.989
2
0.747
0.633
0.019
1.000
3
0.597
0.626
0.000
1.000
4
0.572
0.619
0.231
0.852
5
0.667
0.655
0.135
0.965
Mean
0.627
0.639
0.100
0.961
Código
set.seed (123 )# Configuración validación cruzada <- 5 <- 2 <- createFolds (data$ RCP, k = k_outer, list = FALSE )<- 1 : nrow (data)# Inicializar métricas <- numeric (k_outer)<- numeric (k_outer)<- numeric (k_outer)<- numeric (k_outer)# Función de selección de variables tipo wrapper <- function (df, variable_objetivo) {<- rfeControl (functions = rfFuncs, method = "cv" , number = 3 )# Quitar variable objetivo para selección <- df[, setdiff (names (df), variable_objetivo)]<- df[[variable_objetivo]]# Ejecutar RFE <- rfe (x, y, sizes = c (1 : 5 ), rfeControl = control_rfe)return (predictors (resultado))# Bucle externo for (i_outer in 1 : k_outer) {<- indices[folds_outer == i_outer]<- setdiff (indices, test_indices_outer)<- data[train_indices_outer, ]<- data[test_indices_outer, ]<- createFolds (train_outer$ RCP, k = k_inner, list = FALSE )<- numeric (k_inner)<- numeric (k_inner)<- numeric (k_inner)<- numeric (k_inner)for (i_inner in 1 : k_inner) {<- which (folds_inner == i_inner)<- setdiff (1 : nrow (train_outer), test_indices_inner)<- train_outer[train_indices_inner, ]<- train_outer[test_indices_inner, ]<- wrapper_seleccion (train_inner, "RCP" )<- c ("RCP" , variables_seleccionadas)<- train_inner[, vars, drop = FALSE ]<- val_inner[, vars, drop = FALSE ]# Hiperparámetros <- expand.grid (cp = c (0.01 , 0.05 , 0.1 ),minsplit = c (5 , 10 ),minbucket = c (5 , 10 ))<- 0 <- NULL for (params in 1 : nrow (param_grid)) {<- param_grid$ cp[params]<- param_grid$ minsplit[params]<- param_grid$ minbucket[params]<- rpart (RCP ~ ., data = train_inner,method = "class" ,control = rpart.control (cp = cp, minsplit = minsplit, minbucket = minbucket))<- predict (modelo, newdata = val_inner, type = "prob" )[, "SI" ]<- roc (val_inner$ RCP, prob, levels = rev (levels (val_inner$ RCP)))<- auc (roc_obj)if (auc_val > mejor_auc) {<- auc_val<- modelo# Evaluar en validación <- predict (mejor_modelo, newdata = val_inner, type = "prob" )[, "SI" ]<- ifelse (prob >= 0.85 , "SI" , "NO" )<- sum (pred == "SI" & val_inner$ RCP == "SI" )<- sum (pred == "NO" & val_inner$ RCP == "SI" )<- sum (pred == "SI" & val_inner$ RCP == "NO" )<- sum (pred == "NO" & val_inner$ RCP == "NO" )<- TP / (TP + FN)<- (TP + TN) / (TP + TN + FP + FN)<- TN / (TN + FP)<- mejor_auc<- accuracy<- recall<- specificity# Resultados externos <- mean (resultados_auc_inner)<- mean (resultados_accuracy_inner)<- mean (resultados_sensibilidad_inner)<- mean (resultados_specificity_inner)# Tabla final <- data.frame (Pliegue = 1 : k_outer,AUC = round (resultados_auc, 3 ),Accuracy = round (resultados_accuracy, 3 ),Recall = round (resultados_sensibilidad, 3 ),Specificity = round (resultados_specificity, 3 )<- rbind (tabla_metricas, data.frame (Pliegue = "Mean" ,AUC = round (mean (resultados_auc), 3 ),Accuracy = round (mean (resultados_accuracy), 3 ),Recall = round (mean (resultados_sensibilidad), 3 ),Specificity = round (mean (resultados_specificity), 3 )# Mostrar con kableExtra %>% kable ("html" , caption = "Métricas de DT con Wrapper" ) %>% kable_styling (full_width = TRUE , bootstrap_options = c ("striped" , "hover" , "condensed" )) %>% row_spec (0 , background = "#002859" , color = "white" ) %>% row_spec (1 : (nrow (tabla_metricas)- 1 ), background = "#00AEDA" ) %>% row_spec (nrow (tabla_metricas), bold = TRUE , background = "#007A99" , color = "white" )
Métricas de DT con Wrapper
1
0.471
0.557
0.038
0.864
2
0.727
0.662
0.135
0.977
3
0.648
0.647
0.231
0.897
4
0.567
0.626
0.000
1.000
5
0.628
0.619
0.231
0.852
Mean
0.608
0.622
0.127
0.918
Conclusiones
En esta segunda actividad se ha llevado a cabo una implementación exhaustiva de distintos modelos predictivos para estimar la probabilidad de respuesta completa patológica (RCP) en pacientes con cáncer de mama. Se han evaluado tanto enfoques clásicos como la regresión logística, como modelos más complejos de aprendizaje automático, incluyendo redes neuronales, máquinas de vectores soporte (SVM) y árboles de decisión. Para todos ellos se aplicaron técnicas de selección de variables, ya sea mediante métodos tipo filtro o tipo wrapper, con el fin de mejorar su rendimiento y su utilidad clínica.
En el caso de los modelos de aprendizaje profundo, como redes neuronales y SVM, el proceso de ajuste se dividió en dos fases: primero se exploraron múltiples combinaciones de hiperparámetros y se seleccionó aquella que mostró el mejor rendimiento (según AUC) en un conjunto de validación interna. Luego, esta configuración óptima fue aplicada para entrenar el modelo completo, que fue evaluado utilizando una validación cruzada externa 5x2, garantizando una estimación robusta y realista del desempeño general.
Entre todos los algoritmos de aprendizaje profundo evaluados, el mejor resultado se obtuvo con una red neuronal entrenada tras una selección de variables por método de filtrado. Este modelo alcanzó un AUC de 0.896 en su mejor configuración (15 neuronas ocultas, decay de 0.001 y 5 iteraciones), lo que evidencia que una arquitectura simple, bien regularizada y controlada en su entrenamiento, puede ser altamente competitiva.
Las máquinas de vectores soporte (SVM), evaluadas con distintos valores de cost y gamma usando un kernel radial, también mostraron un rendimiento destacado. La mejor configuración alcanzó un AUC de 0.8906, confirmando la capacidad de las SVM para construir clasificadores robustos con buena generalización.
No obstante, a pesar del buen rendimiento de estos modelos complejos, ninguno logró superar consistentemente al modelo de regresión logística. Este último fue optimizado de forma sistemática mediante búsqueda exhaustiva sobre todas las combinaciones posibles de variables, y evaluado utilizando validación cruzada completa. Su equilibrio entre rendimiento, simplicidad e interpretabilidad lo posicionó como la mejor alternativa en este contexto.
Por este motivo, el modelo de regresión logística fue finalmente seleccionado como base para la herramienta clínica desarrollada en Shiny, ofreciendo una solución práctica, robusta y fácilmente interpretable por profesionales de la salud.
En conclusión, aunque los modelos avanzados de aprendizaje profundo presentan un alto potencial y han demostrado rendimientos competitivos tras una adecuada optimización, el enfoque clásico de regresión logística, bien ajustado y evaluado, sigue siendo la opción más eficaz y recomendable para esta tarea clínica.
↑